Network Review Notes
从网络分层到协议与性能指标,整理计算机网络的核心概念、公式和易混淆点。
目录
本文按网络分层(物理层、链路层、网络层、传输层、应用层)整理要点,并在物理层补充常见线路编码与带通调制的简介,便于复习与查阅。
upd: 计网考试考了 81 分, 这告诉我们学会课程是绝对不如做考研题的。
体系结构与参考模型 #
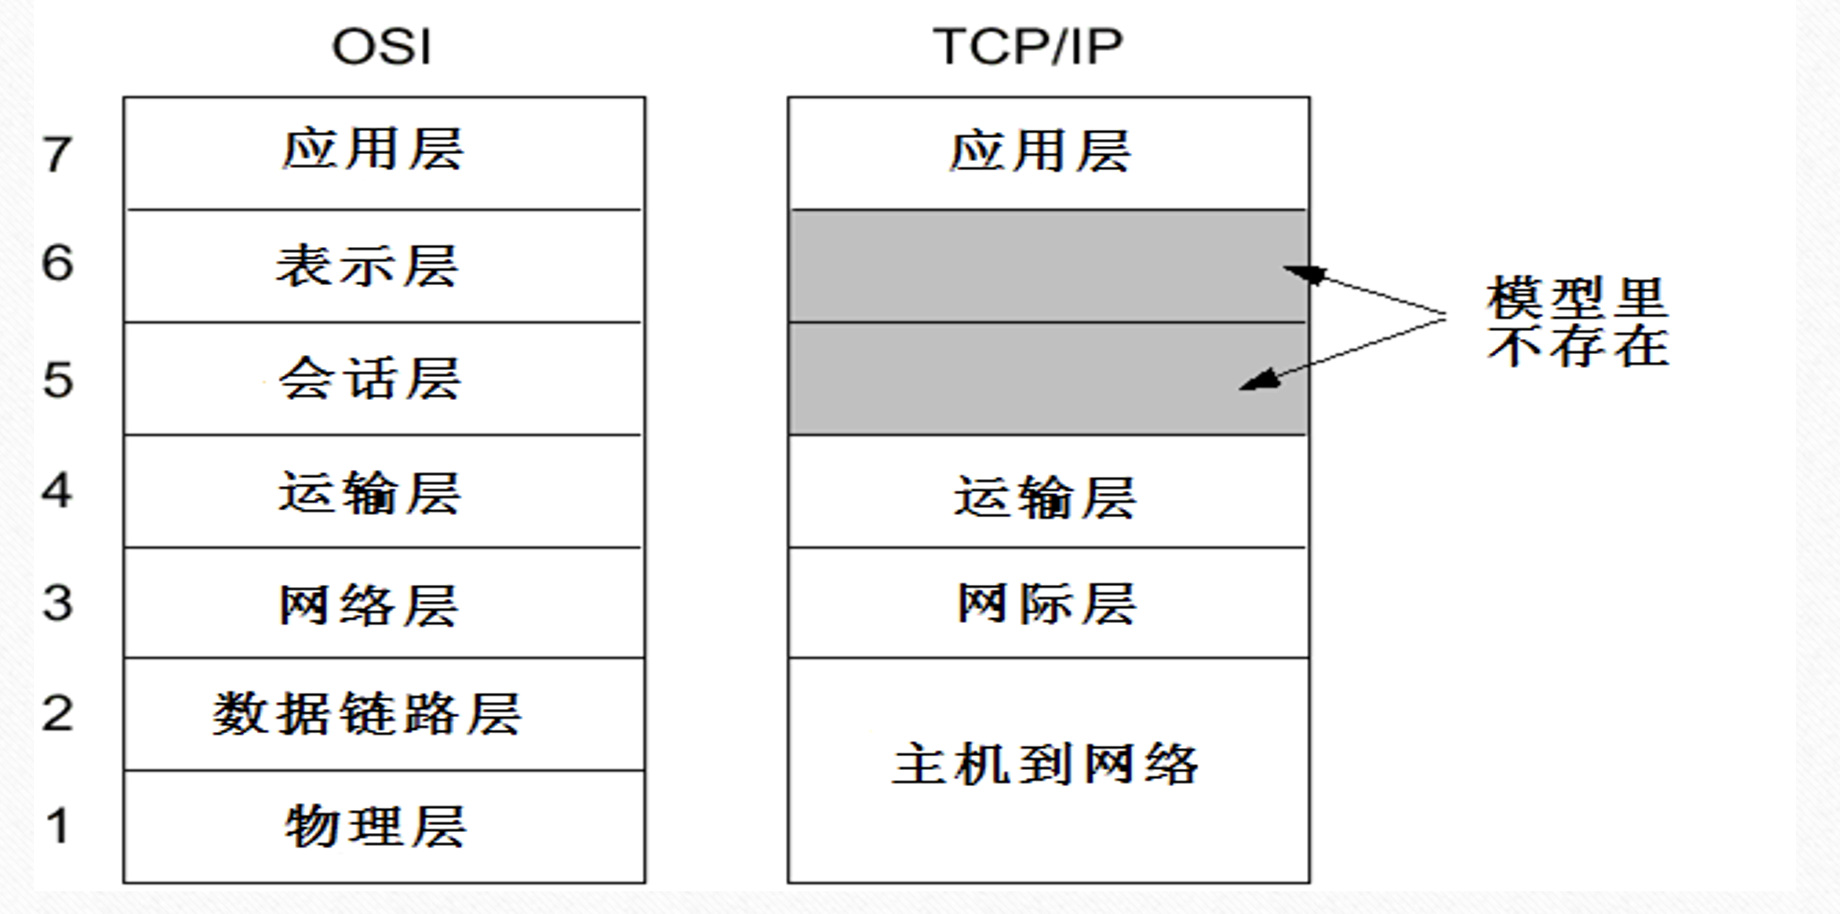
OSI 七层模型 vs TCP/IP 五层模型
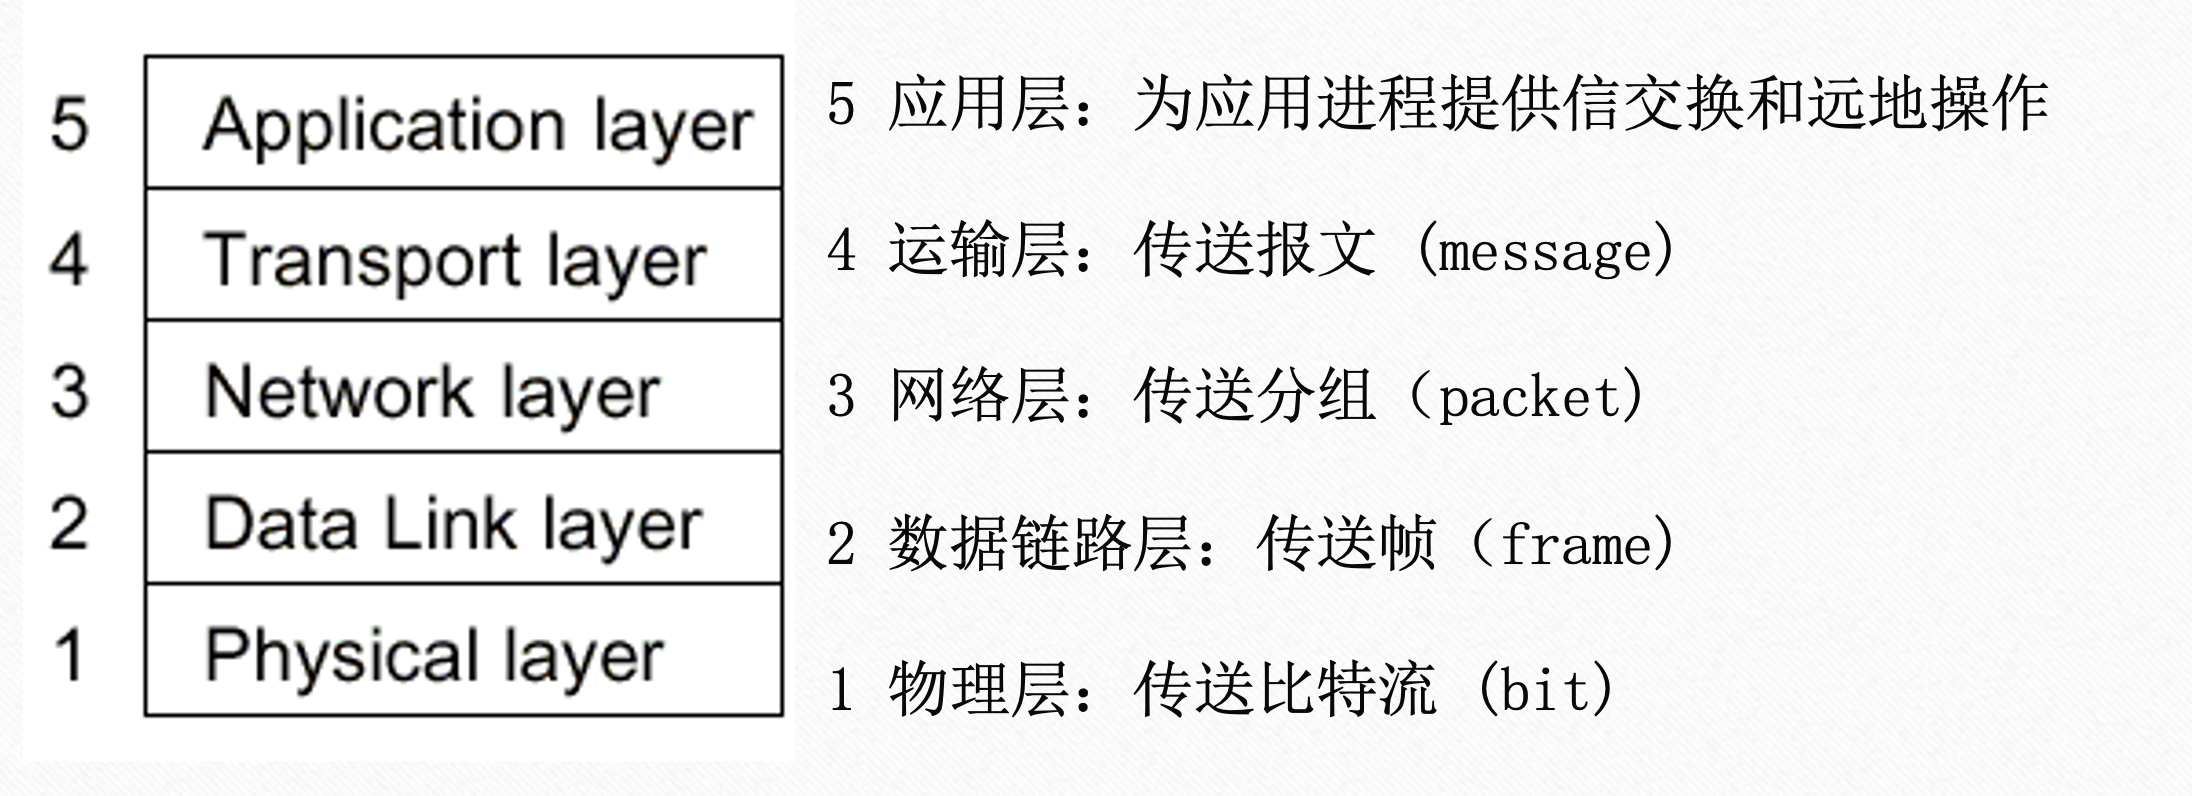
TCP/IP 五层模型各层传输单元
计算机网络性能指标 #
分组经历的四种时延 (Packet Delay) #
一个分组从一台主机(或路由器)传输到另一台主机(或路由器)的过程中,总时延 () 主要由四部分组成:
- 处理时延 (Processing Delay, )
- 定义:检查分组首部和决定将该分组导向何处所需要的时间。包括检查比特级差错。
- 量级:通常是微秒级。
- 排队时延 (Queueing Delay, )
- 定义:分组在链路上等待传输时,在路由器缓冲队列中排队等待的时间。
- 特点:取决于网络的拥塞程度,是最不确定、变化最大的时延分量。
- 传输时延 (Transmission Delay, )
- 定义:将分组的所有比特推向链路所需要的时间。也叫发送时延。
- 公式:
- :分组长度 (bits)
- :链路带宽 (bps)
- 传播时延 (Propagation Delay, )
- 定义:比特在物理链路(介质)中从一端传播到另一端所需要的时间。
- 公式:
- :链路长度 (m)
- :信号传播速度 (m/s, 光纤中约为 m/s)
易混淆点:
- 传输时延取决于带宽和包长(车队过收费站的时间)。
- 传播时延取决于距离和介质速度(车在高速公路上开的时间)。
物理层(Physical Layer) — 编码与调制 #
采样与信道极限 #
- 采样定理:采样频率 。
- 奈奎斯特(无噪声):最大速率 。
- 香农(有噪声):信道容量 。
线路编码详解(基带传输) #
以下示意图使用数据序列:0 1 0 0 1 1
1. 不归零编码 (NRZ - Non-Return to Zero) #
- NRZ-L (Level):高电平代表 1,低电平代表 0。
- NRZI (Inverted):电平翻转代表 1,电平保持代表 0。
- 缺点:存在直流分量;缺乏同步能力(连续的 0 或 1 会导致时钟漂移)。
2. 曼彻斯特编码 (Manchester Encoding) #
- 原理:将每个比特周期分为两半,在周期中间进行电平跳变。
- 跳变即时钟:中间的跳变既作为数据信号,也作为时钟信号(Self-clocking)。
- 编码规则 (IEEE 802.3 标准):
- 1:从低电平跳变到高电平 ()。
- 0:从高电平跳变到低电平 ()。
- 优点:
- 自带时钟同步:接收端容易提取时钟信号。
- 无直流分量:正负电平相互抵消。
- 缺点:
- 频带利用率低:信号频率是数据率的 2 倍。
- 应用:10BASE-T 以太网。
3. 差分曼彻斯特编码 (Differential Manchester) #
- 原理:
- 周期中间:始终有跳变(用于时钟同步)。
- 位开始处:
- 有跳变 表示 0。
- 无跳变 表示 1。
- 优点:
- 继承了曼彻斯特编码的优点(自同步、无直流)。
- 抗干扰性更强:利用电平跳变的相对关系而非绝对极性来表示数据。
- 应用:令牌环网 (Token Ring)。
4. AMI (Alternate Mark Inversion) #
- 规则:0 为零电平;1 为正负电平交替(例如:+V, -V, +V…)。
- 特点:无直流分量,但连续的 0 仍可能导致同步丢失(需配合扰码技术如 HDB3)。
线码与块编码(用于时钟、直流平衡与效率提升) #
- 4B/5B:将 4 比特映射为 5 比特代码(保证足够的转换以恢复时钟),常与 MLT-3 配合用于 100BASE-TX。
- MLT-3:多电平传输(多用于 100BASE-TX),电平序列循环以降低频谱带宽。
带通调制(用于无线与宽带链路) #
- ASK (Amplitude Shift Keying):振幅改变表示比特。
- FSK (Frequency Shift Keying):频率改变表示比特(例如蓝牙早期使用 FSK)。
- PSK (Phase Shift Keying):相位改变表示比特;QPSK 用两个比特/符号。
- QAM (Quadrature Amplitude Modulation):幅度与相位联合,用于高阶星座(例如 16-QAM、64-QAM),提高频谱效率。
实用注记 #
- 10BASE-T 使用 Manchester;100BASE-TX 使用 4B/5B + MLT-3;千兆与更高速以太网使用更复杂的 PAM 与多电平方案。
链路层(Data Link Layer) — MAC、帧结构与差错检测 #
- 以太网帧:前导码 + 目的/源 MAC + 类型/长度 + 数据 + CRC;最小载荷 46B(不足填充)。
- 差错检测:CRC(循环冗余校验)。
- 地址解析:ARP 将 IP 映射为 MAC。
ARP 地址解析协议 (Address Resolution Protocol) #
ARP 解决了已知 IP 地址,求 MAC 地址的问题,是实现链路层传输的关键。
1. 工作流程 #
- 查表:主机 A 想发数据给主机 B (IP_B),先查本地 ARP 缓存表。若命中,直接使用。
- 广播请求:若未命中,A 广播发送 ARP Request(目的 MAC 为
FF-FF-FF-FF-FF-FF),询问:“谁是 IP_B?请告诉我你的 MAC。” - 单播响应:本局域网内所有主机收到请求,只有 B 识别出是找自己,于是单播发送 ARP Reply 给 A:“我是 IP_B,我的 MAC 是 MAC_B。”
- 更新缓存:A 收到后,将 (IP_B, MAC_B) 写入 ARP 缓存,并发送数据帧。
2. 什么时候用到 ARP? #
只要涉及到封装 MAC 帧,就需要用到 ARP。具体分为两种情况:
- 同一局域网内通信:
- 源主机判断目的 IP 在同一网段。
- 直接请求目的主机 IP 对应的 MAC 地址。
- 跨网段通信(访问互联网):
- 源主机判断目的 IP 不在同一网段。
- 源主机需要将包发给默认网关(路由器)。
- 此时,源主机请求的是网关 IP 对应的 MAC 地址(而不是最终目的主机的 MAC)。
- 注意:MAC 地址只在一段链路(Hop-to-Hop)内有效,每经过一个路由器,源/目 MAC 都会改变。
3. 免费 ARP (Gratuitous ARP) #
主机启动或 IP 变更时,主动广播关于自己的 ARP 请求。用于:
- 检测 IP 冲突:若收到回复,说明 IP 被占用。
- 更新邻居缓存:告知其他主机自己 MAC 变了(如双机热备切换)。
多址访问(MAC) #
- 信道划分:TDMA / FDMA / CDMA(重负载场景)。
- 随机访问:纯 ALOHA、时隙 ALOHA、CSMA、CSMA/CD(有线)、CSMA/CA(无线)。
- 轮流方法:轮询、令牌环(Token Ring)。
ALOHA 协议详解 #
ALOHA 协议是随机接入(Random Access)协议的鼻祖,虽然现代网络很少直接使用,但它是理解 CSMA 的基础。
1. 纯 ALOHA (Pure ALOHA) #
- 基本思想:想发就发。
- 用户有数据要发送时,立即发送。
- 发送完后,等待确认 (ACK)。
- 若收到 ACK,发送成功;若超时未收到 ACK,则认为发生冲突,等待一个随机时间后重传。
- 冲突分析:
- 假设帧长为 。
- 若 时刻发送一帧,那么在 这段时间内(共 ),如果有其他用户也发送了帧,就会发生冲突。
- 冲突危险期 (Vulnerable Period):。
- 效率计算:
- 假设帧的到达(包括重传)服从泊松分布,平均每个帧传输时间内产生的帧数为 (网络负载)。
- 吞吐量 (成功发送的帧数/帧传输时间)与 的关系为:
- 推导:一个帧成功发送,意味着在它开始前的 时间内和结束后的 时间内(共 )没有其他帧生成。概率为 。
- 最大值:当 时,取得最大效率 。
2. 时隙 ALOHA (Slotted ALOHA) #
- 改进:将时间划分为等长的时隙 (Slot),时隙长度等于一个帧的传输时间 。
- 规则:
- 站点只能在每个时隙的开始时刻发送帧。
- 如果用户在时隙中间产生了数据,必须等到下一个时隙开始才能发送。
- 冲突分析:
- 因为强制对齐了发送时间,只有在同一个时隙内有两个或以上站点发送才会冲突。
- 冲突危险期:减半为 。
- 效率计算:
- 冲突危险期减半,成功概率为在该时隙内只有 1 帧到达的概率 。
- 公式变为:
- 最大值:当 时,取得最大效率 。
CSMA (Carrier Sense Multiple Access) #
CSMA 改进了 ALOHA,核心思想是 “先听后发” (Listen before talk)。
- 原理:发送前先监听信道。若信道忙,则推迟发送;若信道空闲,则按某种策略发送。
- 冲突原因:虽然先听后发,但由于 传播时延 (Propagation Delay) 的存在,当一个站点发送数据后,信号尚未到达另一个站点时,后者仍可能检测到信道空闲而发送数据,从而导致冲突。
CSMA 的三种监听策略 #
CSMA 的核心是“先听后发”,根据监听结果的不同处理方式,分为:
- 1-坚持 (1-persistent):
- 若信道空闲,立即发送 (概率 1)。
- 若信道忙,持续监听,直到空闲立即发送。
- 缺点:若两个站点同时监听到变为空闲,立即发送会导致冲突。
- 非坚持 (Non-persistent):
- 若信道空闲,立即发送。
- 若信道忙,放弃监听,等待一个随机时间后再来监听。
- 优点:减少冲突;缺点:信道利用率低(可能信道空闲了但大家都在等)。
- p-坚持 (p-persistent):
- 若信道空闲,以概率 p 发送,概率 1-p 推迟到下一个时隙。
- 若信道忙,持续监听(类似 1-坚持)。
- 平衡:在冲突概率和信道利用率之间折中。
CSMA/CD (Carrier Sense Multiple Access with Collision Detection) #
用于有线以太网(半双工)
- 核心机制:
- 先听后发 (Carrier Sense):发送前监听信道,空闲则发送,忙则等待。
- 边发边听 (Collision Detection):发送过程中持续监听信道电平。
- 冲突停止:一旦检测到冲突(电平叠加),立即停止发送数据,并发送人为干扰信号 (Jamming Signal) 强化冲突,通知所有站点。
- 随机重发:执行二进制指数退避算法,等待一段时间后重试。
- 关键参数:
- 争用期 (Contention Period): (两倍端到端传播时延)。
- 最小帧长:。必须保证在发送完一帧之前,信号能跑个来回,确保能检测到最远端的冲突。
- 二进制指数退避算法 (Truncated Binary Exponential Backoff):
- 目的:动态适应网络负载。冲突次数越多,说明网络负载越重,需要等待更长时间以减少再次冲突的概率。
- 算法流程:
- 确定基本退避时间,一般为争用期 。
- 定义重传次数 ,且 (截断机制,超过 10 次后范围不再扩大)。
- 从整数集合 中随机取出一个数 。
- 重传所需的退避时间为 。
- 当重传达 16 次仍不能成功时,丢弃该帧并向高层报错。
- 举例:
- 第 1 次冲突:,范围 ,等待 或 。
- 第 2 次冲突:,范围 ,最大等待 。
- …
- 第 10 次冲突:,范围 。
- 效率:近似公式 。
CSMA/CA (Carrier Sense Multiple Access with Collision Avoidance) #
用于无线局域网 (IEEE 802.11)
为什么不用 CD?
- 检测困难:无线信号衰减剧烈,发送方本地信号强度远大于接收到的远端信号,难以在发送时检测到冲突。
- 隐蔽站问题 (Hidden Terminal):A 和 C 都想发给 B,但 A 听不到 C,导致 A 以为信道空闲而发送,在 B 处发生冲突。
完整传输过程详解 (DIFS -> 退避 -> RTS -> CTS -> Data -> ACK) 无线传输是一个有序的交互过程,通过不同的帧间间隔 (IFS) 来区分优先级。
- DIFS (Distributed Inter-Frame Space):
- 作用:发送方在发送数据帧(或 RTS)前,必须先检测到信道空闲并持续等待 DIFS 时间。
- 目的:确保信道确实空闲,且让高优先级帧(如 ACK,使用更短的 SIFS)有机会先发送。
- 随机退避 (Random Backoff):
- 作用:经过 DIFS 后,若信道仍空闲,发送方启动倒计时(随机选择一个 slot 数)。
- 目的:避免多个站点同时等待 DIFS 结束后立即发送导致冲突。
- RTS (Request To Send) [可选]:
- 作用:发送方广播“请求发送”,包含预约时长(传输数据+ACK所需时间)。
- 目的:解决隐蔽站问题;预约信道。
- SIFS (Short Inter-Frame Space):
- 作用:最短的帧间间隔,用于 RTS/CTS/Data/ACK 之间的切换。
- 目的:确保正在进行的交互序列不被其他站点打断(因为 SIFS < DIFS,其他人还在等 DIFS 时,这边 SIFS 已经发完了)。
- CTS (Clear To Send):
- 作用:接收方收到 RTS 后,等待 SIFS,广播“允许发送”,也包含预约时长。
- 目的:通知发送方可以发了;同时通知周围所有站点(包括隐蔽站)在接下来的时间内保持静默(设置 NAV)。
- Data (数据帧):
- 作用:发送方收到 CTS 后,等待 SIFS,发送真正的数据。
- ACK (确认帧):
- 作用:接收方收到数据并校验无误后,等待 SIFS,回复 ACK。
- 目的:由于没有冲突检测 (CD),发送方必须依靠 ACK 来确认发送成功。若未收到 ACK,则重传。
NAV (Network Allocation Vector):虚拟载波监听机制。其他站点收到 RTS 或 CTS 中的“预约时长”后,会更新自己的 NAV 计时器,在倒计时结束前不尝试发送数据,即使物理信道看起来是空闲的。
- DIFS (Distributed Inter-Frame Space):
无线局域网的差错控制 #
由于无线信道误码率较高,802.11 在链路层引入了严格的差错控制机制,不同于有线以太网(有线通常只检错不重传,靠高层 TCP 保证可靠性)。
- 帧校验 (Frame Validation):
- 采用 CRC-32 (32位循环冗余校验) 生成 FCS (Frame Check Sequence) 字段。
- 接收方计算 CRC,若不匹配则直接丢弃帧(不发 NAK,也不发 ACK)。
- 重传机制 (Retransmission):
- 采用 停止-等待协议 (Stop-and-Wait ARQ)。
- 发送方发完一帧后,必须等待接收方回复 ACK。
- 若在规定时间内未收到 ACK(例如因为帧丢失或 ACK 丢失),发送方会自动重传。
- 注:这是链路层的重传,比传输层 TCP 重传更快,能掩盖无线链路的高误码率。
信道利用率 (Channel Utilization) #
- 定义:发送方处于发送数据状态的时间占总时间的比例。
- 停等协议 (Stop-and-Wait):
- 发送一帧的时间:。
- 往返时间:。
- 利用率公式: 其中 (传播时延 / 发送时延)。
- 滑动窗口协议 (Sliding Window):
- 设窗口大小为 。
- 若 ,则 。
- 若 ,则 (信道被填满)。
局域网互连与交换机转发 #
局域网内的通信主要依靠以太网交换机 (Switch),它工作在链路层。
1. 交换以太网 (Switched Ethernet) 与冲突消除 #
交换以太网是指以交换机 (Switch) 为核心设备构建的星形拓扑以太网。它本质上消除了冲突,原因如下:
- 独占冲突域 (Micro-segmentation):
- 集线器 (Hub):所有端口属于同一个冲突域。A 发数据,B 就不能发。
- 交换机 (Switch):每个端口是一个独立的冲突域。端口 A 的通信不会干扰端口 B。
- 全双工通信 (Full Duplex):
- 交换机与主机之间通常使用全双工链路(发送和接收使用不同线对)。
- 这意味着主机可以同时发送和接收,物理上消除了“发送”与“接收”信号的碰撞。
- 内部交换与缓存:
- 若 A 和 C 同时发给 B,交换机会将帧缓存在队列中排队转发,而不是让信号在线缆上叠加(碰撞)。
- 因此,在全双工交换以太网中,CSMA/CD 协议实际上不再被触发。
2. 交换机工作原理:自学习与转发 #
交换机维护一张交换表 (Switch Table),记录 (MAC 地址, 接口, 时间戳)。
- 自学习 (Self-learning):
- 当交换机收到一个帧时,记录源 MAC 和入端口的映射关系。
- “原来 MAC A 在接口 1 那边”。
- 转发与过滤 (Forwarding & Filtering):
- 检查帧的目的 MAC。
- 已知 (查表命中):若目的 MAC 在表中,且对应接口与入接口不同,则单播转发到该接口;若相同(在同一网段),则丢弃(过滤)。
- 未知 (查表未命中):向除入端口外的所有端口泛洪 (Flood)。
- 广播帧:始终泛洪。
3. 广播域与 VLAN #
- 广播域:交换机的所有端口属于同一个广播域(广播帧会传遍整个网络)。路由器隔离广播域。
- VLAN (Virtual LAN):在交换机上逻辑划分广播域。不同 VLAN 间通信需通过路由器。
局域网通信综合示例:H1 发送数据给 H4 #
基于同网段通信场景(如 H1: 192.168.0.1 -> H4: 192.168.0.4),结合 主机 ARP 缓存表 与 交换机转发表 的交互流程。
1. 预处理:判断网段
- H1 用自己的子网掩码与 H4 的 IP 进行“与”运算,发现与自己在同一网段。
- 结论:直接交付,目标 MAC 应为 H4 的 MAC。
2. 情况 A:H1 的 ARP 缓存表中有 H4
- H1 行为:直接从 ARP 表中查出 H4 的 MAC,封装数据帧(目 MAC = MAC_H4),发送给交换机。
- 交换机行为:收到帧后,查找转发表 (MAC Table)。
- 若表中存在 MAC_H4 的记录,则从对应接口单播转发。
- 若表中不存在,则泛洪。
3. 情况 B:H1 的 ARP 缓存表中无 H4
- H1 行为 (ARP 请求):
- 发送 ARP Request。
- 封装:源 MAC = MAC_H1,目 MAC =
FF:FF:FF:FF:FF:FF(广播)。
- 交换机行为 (泛洪):
- 收到广播帧,向除入接口外的所有接口转发。
- 自学习:记录 MAC_H1 对应的入接口。
- H4 行为 (ARP 响应):
- 收到 ARP 请求,发现问的是自己。
- 发送 ARP Reply (单播)。
- 封装:源 MAC = MAC_H4,目 MAC = MAC_H1。
- 交换机行为 (转发):
- 收到单播帧,查找转发表(此时已有 MAC_H1 记录),将帧转发给 H1。
- 自学习:记录 MAC_H4 对应的入接口。
- H1 行为 (数据传输):
- 收到 ARP Reply,更新 ARP 缓存表。
- 开始发送真实数据帧(同情况 A)。
网络层(Network Layer) — IP 与路由 #
- IP:无连接、不可靠,负责寻址与分片(MTU 限制)。
- 路由:静态/动态(RIP、OSPF、BGP 概念)。
- 子网与掩码:CIDR 表示法,注意网络/主机位划分。
IP 地址分类与特殊地址 #
1. 分类编址 (Classful Addressing) #
虽然现在普遍使用 CIDR (无类别域间路由),但理解分类编址仍是基础。
- A 类:
0开头 (1.0.0.0 - 126.0.0.0),默认掩码 /8。 - B 类:
10开头 (128.0.0.0 - 191.255.0.0),默认掩码 /16。 - C 类:
110开头 (192.0.0.0 - 223.255.255.0),默认掩码 /24。 - D 类:
1110开头 (224.0.0.0 - 239.255.255.255),用于多播 (Multicast)。 - E 类:
1111开头 (240.0.0.0 - 255.255.255.255),保留。
2. 特殊 IP 地址 #
| 地址类型 | IP 地址形式 | 源/目 | 用途 |
|---|---|---|---|
| 网络地址 | 主机号全 0 | - | 标识一个网络,不可分配给主机。 |
| 直接广播 | 主机号全 1 | 目 | 在特定网络内广播(例如 192.168.1.255)。 |
| 受限广播 | 255.255.255.255 | 目 | 在本网络内广播,路由器不转发。 |
| 本主机 | 0.0.0.0 | 源 | DHCP 启动时标识本机;路由表中表示默认路由。 |
| 环回地址 | 127.x.x.x | 源/目 | 环回测试 (Loopback),数据不离开本机。常见 127.0.0.1。 |
3. 私有地址 (Private IP) #
用于局域网内部,不可在公网路由(需 NAT 转换)。
- A 类私有:
10.0.0.0/8(10.0.0.0 - 10.255.255.255) - B 类私有:
172.16.0.0/12(172.16.0.0 - 172.31.255.255) - C 类私有:
192.168.0.0/16(192.168.0.0 - 192.168.255.255)
IP 分组转发流程 #
当路由器收到一个 IP 数据报时,处理流程如下:
- 提取目的 IP 地址 ()。
- 判断是否直接交付:
- 检查 是否与路由器某个接口在同一个子网(通过子网掩码计算)。
- 若是,则通过 ARP 获取目的主机的 MAC 地址,将数据报封装成帧,直接交付给目的主机。
- 查找路由表(间接交付):
- 若不是直接交付,则在路由表中查找 。
- 最长前缀匹配 (Longest Prefix Match):若路由表中有多个条目匹配 ,选择掩码最长(最具体)的那个条目。
- 路由表条目通常包含:
(目的网络, 子网掩码, 下一跳 IP, 接口)。
- 转发:
- 找到下一跳 IP () 后,通过 ARP 获取 的 MAC 地址。
- TTL 减 1:若 TTL 变为 0,丢弃包并发送 ICMP 超时报文。
- 重新封装 MAC 帧:源 MAC 变为路由器出接口 MAC,目的 MAC 变为下一跳路由器 MAC。
- 将帧发送出去。
- 默认路由:若路由表中找不到匹配项,且存在默认路由 (
0.0.0.0/0),则转发给默认网关;否则丢弃并发送 ICMP 不可达报文。
跨网段通信示例:IP 与 MAC 的变化 #
理解跨网段转发,关键在于把握 IP 地址端到端不变,MAC 地址逐跳改变 的原则(不考虑 NAT)。
场景:主机 A (192.168.1.2) 发送数据给主机 B (192.168.2.2)。
- 主机 A:MAC_A,网关 R (
192.168.1.1, MAC_R1)。 - 路由器 R:连接网段 1 的接口 MAC_R1,连接网段 2 的接口 MAC_R2。
- 主机 B:MAC_B。
过程 1:主机 A -> 路由器 R
- A 发现 B 不在同一网段,查路由表得知需发给网关 R。
- A 通过 ARP 获取网关 R 的 MAC 地址 (MAC_R1)。
- 封装数据帧:
- 源 IP:
192.168.1.2(A) - 目 IP:
192.168.2.2(B) - 源 MAC:
MAC_A - 目 MAC:
MAC_R1(网关)
- 源 IP:
过程 2:路由器 R -> 主机 B
- R 收到帧,提取 IP 数据报,TTL 减 1。
- R 查路由表,发现 B 在直连网段 (
192.168.2.0/24)。 - R 通过 ARP 获取主机 B 的 MAC 地址 (MAC_B)。
- 重新封装数据帧:
- 源 IP:
192.168.1.2(A) —— 保持不变 - 目 IP:
192.168.2.2(B) —— 保持不变 - 源 MAC:
MAC_R2(路由器出接口) —— 改变 - 目 MAC:
MAC_B(下一跳/最终目的) —— 改变
- 源 IP:
路由类型与优先级 #
在路由表中,路由条目通常分为以下几类,匹配优先级从高到低(基于最长前缀匹配原则):
- 主机路由 (Host Route):
- 掩码:
255.255.255.255(/32)。 - 用途:指向网络中特定的一台主机。
- 优先级:最高。通常用于特殊管理或安全需求。
- 掩码:
- 网络路由 (Network Route):
- 掩码:长度在 1 到 31 之间(如 /24, /16)。
- 用途:指向整个子网。路由表中大部分条目属于此类。
- 默认路由 (Default Route):
- 掩码:
0.0.0.0(/0)。 - 用途:当目的地址在路由表中找不到任何其他匹配项时使用。
- 优先级:最低。
- 掩码:
NAT 网络地址转换 (Network Address Translation) #
NAT 技术主要用于解决 IPv4 地址短缺 问题,允许专用网络(Private Network)内部的主机通过共享少量的公网(Public)IP 地址访问互联网。
1. 基本原理 #
当内网主机向外网发送数据报时,NAT 路由器(网关)将其 源 IP 地址 替换为 NAT 路由器的公网 IP 地址。当外网回复时,NAT 路由器再将 目的 IP 地址 替换回 内网主机的私有 IP。
2. NAPT (Network Address Port Translation) #
最常见的 NAT 实现形式,也称为 PAT (Port Address Translation)。
- 问题:如果只有一个公网 IP,如何区分内网多个主机的流量?
- 解决:利用 传输层端口号。NAT 路由器维护一张 NAT 转换表:
{内网 IP : 内网 Port} <---> {公网 IP : 公网 Port} - 流程示例:
- 出站:内网主机 A (
192.168.1.2:12345) 发送数据。NAT 路由器将其替换为 (203.0.113.5:60001) 发往外网。 - 记录:在 NAT 表中添加条目。
- 入站:外网回复给 (
203.0.113.5:60001)。NAT 路由器查表,发现对应 (192.168.1.2:12345),于是修改目的 IP 和端口并转发给 A。
- 出站:内网主机 A (
3. NAT 的优缺点 #
- 优点:节省公网 IP;隐藏内网结构,增加安全性。
- 缺点:
- 违反了 IP 的“端到端”通信原则。
- 使得 P2P 应用(如 BitTorrent、VoIP)开发困难(需要 NAT 穿透技术,如 STUN/TURN)。
- 消耗路由器性能(需修改 IP/TCP/UDP 头部校验和)。
IP 数据报格式 (IPv4) #
IPv4 数据报由 首部 (Header) 和 数据 (Data) 两部分组成。首部长度可变,但固定部分为 20 字节。
1. 固定首部 (20 Bytes) #
- 版本 (Version) [4 bits]:IP 协议版本,IPv4 为 4。
- 首部长度 (IHL) [4 bits]:单位为 4 字节。最小值为 5 (5*4=20 字节),最大值为 15 (60 字节)。
- 区分服务 (TOS/DS) [8 bits]:用于 QoS,标记优先级、延迟、吞吐量等要求。
- 总长度 (Total Length) [16 bits]:首部 + 数据的总长度,单位字节。最大 65535 字节。
- 标识 (Identification) [16 bits]:计数器,用于分片重组,同一数据报的所有分片具有相同的 ID。
- 标志 (Flags) [3 bits]:
- Bit 0: 保留。
- Bit 1: DF (Don’t Fragment)。置 1 禁止分片。
- Bit 2: MF (More Fragments)。置 1 表示后面还有分片,置 0 表示这是最后一个分片。
- 片偏移 (Fragment Offset) [13 bits]:指出本分片在原数据报中的相对位置。单位是 8 字节。
- 生存时间 (TTL) [8 bits]:防止环路。每经过一个路由器减 1,减至 0 丢弃。
- 协议 (Protocol) [8 bits]:指出数据部分携带的上层协议。
1: ICMP6: TCP17: UDP
- 首部校验和 (Header Checksum) [16 bits]:只校验首部,不校验数据(数据由上层校验)。每跳都需要重新计算(因为 TTL 变了)。
- 源 IP 地址 [32 bits]
- 目的 IP 地址 [32 bits]
2. IP 分片机制与关键字段 #
当 IP 数据报长度超过链路 MTU 时,需要进行分片。涉及的四个关键字段如下:
- 标识 (Identification):同一原始数据报的所有分片拥有相同的标识,用于接收端重组。
- 标志 (Flags):
- DF (Don’t Fragment):若为 1,禁止分片(超限则丢弃并报错)。
- MF (More Fragments):若为 1,表示后续还有分片;若为 0,表示这是最后一个分片。
- 片偏移 (Fragment Offset):表示当前分片在原始数据报中的位置(单位:8 字节)。
- 总长度 (Total Length):分片后,每个分片的首部该字段会被修改为当前分片的总长度(首部+数据)。
重组四元组:接收端通过 源 IP、目的 IP、协议 和 标识 来唯一确定一个分片属于哪个原始数据报。
3. 可变部分 (Options) #
- 长度可变,0 到 40 字节。用于排错、测量、安全等(如记录路由 Record Route、时间戳 Timestamp)。
- 填充 (Padding):确保首部长度是 4 字节的整数倍。
ICMP (Internet Control Message Protocol) #
- 定义:网络层协议,用于在 IP 主机、路由器之间传递控制消息。ICMP 报文封装在 IP 数据报中(Protocol 字段为 1)。
- 功能:
- 差错报告:当 IP 数据报处理出错时,向源主机发送错误报告。
- 终点不可达 (Destination Unreachable):Type 3。路由器无法转发或主机无法交付(如端口不可达)。
- 时间超过 (Time Exceeded):Type 11。TTL 减为 0(用于 Traceroute)或分片重组超时。
- 参数问题 (Parameter Problem):Type 12。首部字段不正确。
- 重定向 (Redirect):Type 5。告知主机有更好的路由路径。
- 网络探测(查询):
- 回送请求/回答 (Echo Request/Reply):Type 8 / 0。用于
ping测试连通性。 - 时间戳请求/回答:用于时钟同步和测量时间。
- 回送请求/回答 (Echo Request/Reply):Type 8 / 0。用于
- 差错报告:当 IP 数据报处理出错时,向源主机发送错误报告。
- 应用原理:
- Ping:发送 ICMP Echo Request,接收 Echo Reply,计算 RTT。
- Traceroute (Windows: tracert):
- 发送 UDP(或 ICMP)数据包,TTL 从 1 开始递增。
- 第 个路由器收到 TTL= 的包,TTL 减为 0,丢弃并回送 ICMP Time Exceeded。
- 源主机收到该 ICMP 报文,记录路由器 IP 和 RTT。
- 到达目的主机时,端口不可达(UDP)或回送应答(ICMP),结束探测。
- 注意:ICMP 差错报文不再产生 ICMP 差错报文(防止无限循环)。
路由协议详解 (Routing Protocols) #
路由协议的核心任务是更新路由表,决定数据包的最佳路径。
1. 协议分类 #
- 内部网关协议 (IGP):在自治系统 (AS) 内部使用。
- RIP (基于距离向量)
- OSPF (基于链路状态)
- 外部网关协议 (EGP):在自治系统 之间使用。
- BGP (基于路径向量)
2. RIP (Routing Information Protocol) #
RIP 是最早的内部网关协议之一,基于 距离向量 (Distance Vector) 算法。
- 核心特征:
- 算法:Bellman-Ford 算法。
- 度量 (Metric):跳数 (Hop Count)。每经过一个路由器跳数 +1。
- 限制:最大跳数为 15。16 跳表示不可达(Infinity)。这限制了 RIP 只能用于小型网络。
- 工作机制:
- 仅和相邻路由器交换信息:不知道全网拓扑,只知道“去往某地,下一跳给谁,距离多远”。
- 交换全部路由表:将自己知道的所有路由信息告诉邻居。
- 周期性更新:默认每 30秒 广播一次路由表(UDP 520端口)。
- 问题:坏消息传得慢 (Count-to-Infinity)
- 当网络出现故障(如某链路断开)时,路由器之间可能会互相传播过时的路由信息,导致跳数不断增加直到 16,收敛非常慢。
- 防环机制:
- 水平分割 (Split Horizon):从接口 A 学到的路由,不再从接口 A 发回给邻居。(我不把从你那学到的东西再告诉你)。
- 毒性逆转 (Poison Reverse):从接口 A 学到的路由,发回给邻居时,将跳数设为 16(不可达)。 (我明确告诉你这条路我不通,防止你以为我能通)。
- 触发更新 (Triggered Update):一旦拓扑变化,立即发送更新,不等待 30秒周期。
3. OSPF (Open Shortest Path First) #
OSPF 是目前最广泛使用的 IGP,基于 链路状态 (Link State) 算法。
- 核心特征:
- 算法:Dijkstra 最短路径优先 (SPF) 算法。
- 度量 (Metric):开销 (Cost)。通常与带宽成反比 ()。
- 协议号:IP 协议号 89(直接封装在 IP 包中,不使用 UDP/TCP)。
- 五种报文类型:
- Hello:周期性发送,用于发现和维护邻居关系,选举 DR/BDR。
- DBD (Database Description):发送 LSDB 的摘要信息,用于比对数据库是否同步。
- LSR (Link State Request):请求特定的 LSA 详细信息。
- LSU (Link State Update):发送 LSA(链路状态通告),这是承载路由信息的核心报文。
- LSAck:对收到的 LSU 进行确认。
- 工作流程:
- 建立邻居:通过 Hello 包建立邻接关系。
- 泛洪 LSA:路由器向本区域内所有路由器泛洪 LSA(告知“我有哪些邻居,链路质量如何”)。
- LSDB 同步:所有路由器最终建立一个全网一致的链路状态数据库 (LSDB)(即全网拓扑图)。
- SPF 计算:每个路由器以自己为根,独立运行 Dijkstra 算法,计算到达各目的地的最短路径树,生成路由表。
- 区域 (Area) 划分:
- 为了支持大型网络,OSPF 将 AS 划分为多个区域。
- 骨干区域 (Area 0):核心区域,负责连接其他区域。
- 非骨干区域:必须通过 Area 0 进行通信。
- 优点:LSA 泛洪被限制在区域内,减少了路由器的计算和存储负担。
4. RIP vs OSPF 对比总结 #
| 特性 | RIP | OSPF |
|---|---|---|
| 类型 | 距离向量 (Distance Vector) | 链路状态 (Link State) |
| 算法 | Bellman-Ford | Dijkstra (SPF) |
| 度量值 | 跳数 (Hop) | 带宽 (Cost) |
| 收敛速度 | 慢 (坏消息传得慢) | 快 (拓扑变化立即泛洪) |
| 网络规模 | 小型 (最大 15 跳) | 大中型 (支持区域划分) |
| 交换信息 | 整个路由表 | 链路状态 (LSA) |
| 交换对象 | 仅相邻路由器 | 区域内所有路由器 (泛洪) |
| 协议层 | 应用层 (UDP 520) | 网络层 (IP 89) |
| 防环机制 | 水平分割、毒性逆转、最大跳数 | 算法本身无环 (基于拓扑树) |
移动 IP (Mobile IP) #
移动 IP 标准允许移动设备在切换网络接入点时,保持其 IP 地址不变,从而保证正在进行的网络连接(如 TCP 连接)不中断。
1. 核心实体与术语 #
- 移动节点 (MN, Mobile Node):漫游的主机(如手机、笔记本)。
- 家乡代理 (HA, Home Agent):位于 MN 家乡网络 (Home Network) 的路由器。它负责拦截发往 MN 家乡地址的数据包,并转发给 MN。
- 外地代理 (FA, Foreign Agent):位于 MN 当前所在的 外地网络 (Foreign Network) 的路由器。它为 MN 提供转交地址,并协助 MN 向 HA 注册。(注:在 IPv6 或某些 IPv4 模式中,MN 可自行管理转交地址,无需 FA)。
- 通信对端 (CN, Correspondent Node):与 MN 通信的对方主机。
2. 两种 IP 地址 #
- 永久地址 (Permanent Address / Home Address):MN 在家乡网络中的原始 IP 地址。无论 MN 移到哪里,该地址不变,CN 始终向该地址发送数据。
- 转交地址 (COA, Care-of Address):MN 在外地网络获得的临时 IP 地址。
- 通常是 FA 的 IP 地址(FA-COA)。
- 或者是通过 DHCP 在外地网络获得的临时 IP(Colocated COA)。
3. 工作流程 (三角路由问题) #
移动 IP 的通信过程通常呈现“三角形”路径,因为数据流向是不对称的。
- 代理发现 (Agent Discovery):MN 移动到外地网络,收到 FA 的广播通告,获得 COA。
- 注册 (Registration):MN 通过 FA 向 HA 发送注册请求,告知 HA:“我现在在 COA 这个地方”。
- 数据传输 (Data Transfer):
- CN MN (封装/隧道):
- CN 不知道 MN 跑了,仍向 MN 的永久地址发送数据包。
- 数据包到达家乡网络,被 HA 拦截。
- HA 将数据包封装(IP-in-IP 隧道),目的地址设为 COA,转发给 FA。
- FA 收到后解封装,将原始数据包发给 MN。
- MN CN (直接路由):
- MN 发送数据给 CN 时,源 IP 仍填永久地址。
- 数据包通常直接通过外地网络路由给 CN(不需要绕回家乡)。
- 注:这会导致源 IP 与当前网络前缀不匹配,可能被外地网络的入口过滤拦截,需反向隧道解决。
- CN MN (封装/隧道):
4. 间接路由 vs 直接路由 #
- 间接路由 (Indirect Routing):如上所述,CN 发给 HA,HA 转发给 MN。会有“三角路由”带来的延迟。
- 直接路由 (Direct Routing):CN 从 HA 处查询到 MN 的 COA,直接向 COA 发送封装数据。需要 CN 支持移动 IP 协议。
传输层(Transport Layer) — 可靠性与拥塞控制 #
可靠数据传输(RDT)演进 #
- RDT 1.0:理想信道。
- RDT 2.x:处理比特误码,引入 ACK/NAK 与序列号。
- RDT 3.0:处理丢包,引入超时重传与定时器。
流水线协议 #
- GBN (Go-Back-N):接收端单一累积 ACK,超时重传窗口内所有未确认分组。
- SR (Selective Repeat):接收端可缓存乱序分组,只重传超时分组。
TCP / UDP #
- TCP:面向连接,可靠传输,拥塞控制(慢启动、拥塞避免、快速重传/恢复)、流量控制(滑动窗口)。
- UDP:无连接、无保证,适合实时/简单请求场景(如 DNS、实时媒体)。
TCP 报文段结构 (TCP Segment Structure) #
TCP 报文段由首部和数据组成。首部最小长度为 20 字节。
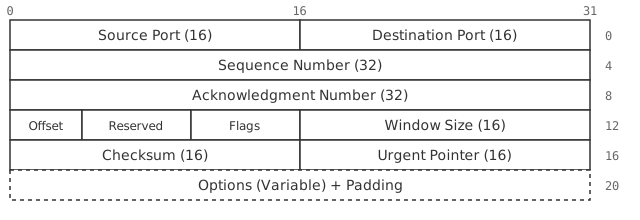
1. 关键字段详解 #
- 源端口与目的端口 (各 16 bits):标识通信双方的应用进程。
- 序列号 (Sequence Number) (32 bits):
- 指出本报文段数据部分的第一个字节的序号。
- TCP 是面向字节流的,每个字节都有序号。
- 确认号 (Acknowledgment Number) (32 bits):
- 期望收到对方下一个报文段的第一个字节的序号。
- 若确认号为 ,则表示到序号 为止的所有数据都已正确收到(累积确认)。
- 首部长度 (Data Offset) (4 bits):
- 指出 TCP 首部有多长(单位为 4 字节)。
- 最小 5 (20 字节),最大 15 (60 字节)。
- 保留 (6 bits):保留为 0。
- 标志位 (Flags) (6 bits):
- URG:紧急指针有效。
- ACK:确认号有效(连接建立后所有传送的报文段都必须把 ACK 置 1)。
- PSH (Push):接收方应尽快将报文段交付应用进程,不再等待缓存填满。
- RST (Reset):连接出错,需释放连接并重新建立。
- SYN (Synchronize):同步序号,用于建立连接。
- FIN (Finish):发送方数据已发完,要求释放连接。
- 接收窗口 (Window Size) (16 bits):
- 告诉对方:“我现在允许你发送的数据量”。
- 用于流量控制,单位为字节。
- 校验和 (Checksum) (16 bits):
- 覆盖首部和数据。
- 计算时需加上 12 字节的伪首部 (Pseudo Header,包含源/目 IP、协议号、TCP 长度),以防止误投递。
- 紧急指针 (Urgent Pointer) (16 bits):只有当 URG=1 时有效,指出紧急数据的末尾在报文段中的位置。
2. 选项 (Options) #
- 长度可变,最长 40 字节。
- MSS (Maximum Segment Size):最大报文段长度。仅在 SYN 报文段中协商,指明本端能接收的最大数据载荷长度(不含 TCP 首部)。
- SACK (Selective Acknowledgment):选择性确认,用于告知发送方哪些非连续的块已收到。
- Window Scale:窗口扩大因子,用于支持超过 65535 字节的窗口(长肥管道)。
TCP 超时与 RTT 估算 #
TCP 使用超时重传机制来处理丢包。超时时间间隔 () 的设置至关重要:太短会导致不必要的重传,太长会导致对丢包反应迟钝。TCP 通过估算 (Round Trip Time) 来动态调整超时时间。
1. SampleRTT #
- 定义:从某报文段被发出(交给 IP)到收到相应确认(ACK)的时间间隔。
- 特点: 会随网络负载波动,单次测量值不稳定。
- 注意:TCP 仅在某时刻测量一次 ,且不为重传的报文段测量(Karn 算法),以避免二义性。
2. EstimatedRTT (加权平均往返时间) #
为了平滑 的波动,TCP 计算加权移动平均值 (EWMA)。
- (推荐值): ()。
- 意义: 更平滑,反映了 RTT 的长期趋势。
- 初始化:在获得第一个 时, 直接取该值。
3. DevRTT (RTT 偏差) #
除了均值,还需要估算 RTT 的波动幅度(方差),用于设置安全裕度。
- (推荐值): ()。
- 意义:反映了 偏离 的程度。
- 初始化:在获得第一个 时, 通常设为 。
4. TimeoutInterval (超时时间间隔) #
超时时间应设置为 加上一定的安全裕度(通常为 4 倍的偏差)。
- 初始值:通常为 1 秒。
- 超时后:若出现超时, 通常加倍(指数退避),而不是重新计算,直到收到新的非重传报文段的 ACK。
5. TCP 重传计时器管理规则 (简化版) #
TCP 通常仅使用单一重传计时器(Single Retransmission Timer),即使有多个已发送但未确认的段。管理逻辑如下:
- 发送数据时:若计时器当前未运行,则启动计时器(过期时间设为 )。
- 收到 ACK 时:
- 若该 ACK 确认了新数据(累积确认):
- 更新 等参数(仅当该段未曾重传,遵循 Karn 算法)。
- 若仍有未确认的数据,重启计时器。
- 若所有数据都已确认,停止计时器。
- 若该 ACK 确认了新数据(累积确认):
- 计时器超时:
- 重传:重传最早那个未被确认的报文段(仅重传一个)。
- 退避:将 加倍(指数退避)。这能有效防止网络拥塞进一步恶化。
- 重启:重启计时器。
TCP 拥塞控制算法变体 #
| 算法 | 核心机制 | 特点 |
|---|---|---|
| TCP Tahoe | 慢启动 + 拥塞避免 + 快速重传 | 任何丢包(超时或 3 个重复 ACK)都将 cwnd 重置为 1,进入慢启动。效率较低。 |
| TCP Reno | + 快速恢复 | 收到 3 个重复 ACK 时,执行快速恢复(cwnd 减半而非重置为 1),跳过慢启动。 |
| TCP NewReno | 改进的快速恢复 | 解决 Reno 在一个窗口内多个包丢失时效率低下的问题。 |
| TCP CUBIC | 三次函数增长 | Linux 默认算法。使用三次函数替代线性增长,更适合高带宽延迟积(BDP)网络。 |
| TCP BBR | 基于模型 (Model-based) | Google 开发。不基于丢包,而是探测带宽和 RTT,旨在最大化吞吐量并最小化延迟。 |
TCP 连接管理 #
- 三次握手 (建立连接):
- SYN (seq=x)
- SYN+ACK (seq=y, ack=x+1)
- ACK (seq=x+1, ack=y+1)
- 四次挥手 (释放连接):
- FIN (主动关闭方)
- ACK (被动关闭方)
- FIN (被动关闭方)
- ACK (主动关闭方,进入 TIME_WAIT 等待 2MSL)
应用层(Application Layer) — 协议演进与常见服务 #
HTTP 超文本传输协议 (HyperText Transfer Protocol) #
HTTP 是 Web 的核心应用层协议,定义了 Web 客户端(浏览器)与 Web 服务器之间交换消息的格式和方式。
1. 基本概念 #
- C/S 架构:Client 发起请求,Server 返回响应。
- 无状态 (Stateless):服务器不维护关于客户的任何信息。即服务器不知道刚才这个 IP 的用户是否访问过。
- 优点:服务器设计简单,支持高性能并发。
- 缺点:无法关联用户操作(如购物车),需引入 Cookie/Session 解决。
- 传输层:基于 TCP (端口 80)。HTTPS 基于 SSL/TLS (端口 443)。
2. HTTP 连接类型 #
- 非持久连接 (Non-persistent Connection) [HTTP/1.0 默认]
- 每个 TCP 连接只传输一个请求/响应对象。
- 传输完毕后立即关闭 TCP 连接。
- 缺点:每个对象都要经历 TCP 三次握手,延迟高;服务器端并发连接数压力大。
- 持久连接 (Persistent Connection) [HTTP/1.1 默认]
- Keep-Alive:服务器在发送响应后保持 TCP 连接打开。后续请求/响应复用该连接。
- 非流水线 (Without Pipelining):发一个请求,等收到响应后再发下一个。
- 流水线 (With Pipelining):客户端可以连续发送多个请求,无需等待响应。服务器按顺序返回响应。(注:因队头阻塞问题,现代浏览器默认并未广泛启用流水线)。
性能分析:响应时间与利用率 #
假设页面包含 1 个基础 HTML 和 个引用对象(忽略传输时延):
- 非持久连接:
- 总耗时:。
- 利用率:极低。大部分时间浪费在握手和等待 RTT 上。
- 持久连接 (非流水线):
- 总耗时:。
- 利用率:中等。节省了握手时间,但每个对象仍需等待上一个对象的 RTT。
- 持久连接 (流水线):
- 总耗时:。
- 利用率:最高。理想情况下,所有对象并行传输,链路几乎被填满。
3. HTTP 报文格式 #
HTTP 报文是纯文本(HTTP/2 之前),人眼可读。
A. 请求报文 (Request Message)
GET /index.html HTTP/1.1      <-- 请求行 (方法 URL 版本)
Host: www.example.com         <-- 首部行 (Header Lines)
User-Agent: Mozilla/5.0
Connection: keep-alive
                              <-- 空行 (CRLF)
(Body) <-- 请求体 (GET 通常为空,POST 有数据)B. 响应报文 (Response Message)
HTTP/1.1 200 OK               <-- 状态行 (版本 状态码 短语)
Date: Thu, 28 Nov 2025...     <-- 首部行
Server: Apache
Content-Type: text/html
Content-Length: 1234
                              <-- 空行
<html>...</html> <-- 响应体 (Entity Body)4. 常见 HTTP 方法 (Methods) #
HTTP 方法定义了客户端希望对资源执行的操作。
| 方法 | 描述 | 安全性 (Safe) | 幂等性 (Idempotent) |
|---|---|---|---|
| GET | 请求指定资源。参数在 URL 中可见。 | ✅ 是 | ✅ 是 |
| HEAD | 类似 GET,但服务器只返回首部,不返回实体主体(用于调试或检查资源是否存在)。 | ✅ 是 | ✅ 是 |
| POST | 向服务器提交数据(如表单)。数据在报文体中。通常用于创建新资源。 | ❌ 否 | ❌ 否 |
| PUT | 上传文件,替换目标资源。若资源不存在则创建。 | ❌ 否 | ✅ 是 |
| DELETE | 删除指定资源。 | ❌ 否 | ✅ 是 |
| PATCH | 对资源进行部分修改。 | ❌ 否 | ❌ 否 (通常) |
| OPTIONS | 询问服务器支持哪些方法(用于 CORS 预检请求)。 | ✅ 是 | ✅ 是 |
| TRACE | 回显服务器收到的请求,主要用于测试或诊断。 | ✅ 是 | ✅ 是 |
| CONNECT | 开启一个双向通信隧道(通常用于通过代理访问 HTTPS)。 | ❌ 否 | ❌ 否 |
概念辨析:
- 安全性 (Safe):操作是否只读,不会修改服务器状态。
- 幂等性 (Idempotent):多次执行同一操作的效果,是否与执行一次的效果相同。
- 例子:
DELETE /id/1是幂等的(删一次和删十次,结果都是该资源不存在);POST /create不是幂等的(发十次可能创建十个资源)。
常见误区:
- 没有 PUSH 方法:HTTP 标准中不存在名为
PUSH的请求方法。
- 如果您是指“服务器主动推送数据”,这是 HTTP/2 Server Push 特性(服务器在响应一个请求时,主动推送其他资源),或者是 WebSocket 协议,而非一种 HTTP 请求方法。
- 如果您是指“上传/提交”,通常使用 POST 或 PUT。
5. 常见状态码 (Status Codes) #
- 1xx:通知信息(如 100 Continue)。
- 2xx:成功。
- 200 OK:请求成功。
- 3xx:重定向。
- 301 Moved Permanently:永久移动(更新书签)。
- 304 Not Modified:资源未修改(使用缓存)。
- 4xx:客户端错误。
- 400 Bad Request:请求语法错误。
- 401 Unauthorized:未授权(需登录)。
- 403 Forbidden:禁止访问。
- 404 Not Found:资源不存在。
- 5xx:服务器错误。
- 500 Internal Server Error:服务器内部错误。
- 502 Bad Gateway:网关错误。
6. Cookie 与 Session #
为了解决 HTTP 无状态的问题:
- Cookie:
- 存储在客户端(浏览器)。
- 服务器在响应头中设置
Set-Cookie: id=123。 - 浏览器后续请求会自动带上
Cookie: id=123。
- Session:
- 存储在服务器端。
- 通常利用 Cookie 传递 SessionID 来关联用户会话。
7. HTTP 版本演进详解 #
| 版本 | 核心特性 | 解决的问题 | 遗留问题 |
|---|---|---|---|
| HTTP/1.0 | 短连接 | 建立了基本的请求/响应模型 | 连接无法复用,性能差 |
| HTTP/1.1 | 持久连接 (Keep-Alive) 管线化 (Pipelining) Host 头 | 减少了 TCP 握手开销 | 队头阻塞 (HOL Blocking):一个请求卡住,后续请求全被堵塞 |
| HTTP/2 | 多路复用 (Multiplexing) 二进制分帧 头部压缩 (HPACK) 服务器推送 | 解决了应用层的队头阻塞;单连接并发多请求 | TCP 队头阻塞:底层 TCP 丢包会导致所有流等待 |
| HTTP/3 | 基于 QUIC (UDP) 0-RTT 建连 连接迁移 (Connection ID) | 彻底解决 TCP 队头阻塞;网络切换不断连 | 部署兼容性(UDP 丢包/限速问题) |
DNS 域名系统 (Domain Name System) #
DNS 是互联网的电话簿,负责将人类可读的主机名 (如 www.example.com) 转换为机器可读的 IP 地址。
1. 层次化命名空间 #
DNS 采用分层树状结构:
- 根域名服务器 (Root):最高层,知道所有 TLD 服务器的地址。
- 顶级域名服务器 (TLD):负责
.com,.org,.cn等顶级域。 - 权威域名服务器 (Authoritative):负责特定组织(如
example.com)的 DNS 记录,提供最终的解析结果。 - 本地域名服务器 (Local DNS):ISP 或企业提供的 DNS,负责代理用户进行查询(通常有缓存)。
2. 查询过程:递归 vs 迭代 #
递归查询 (Recursive Query):
- 含义:“我只要最终结果”。如果被询问的服务器不知道,它必须替询问者去问别人,直到查到结果返回。
- 发生场景:主机 (Client) 本地 DNS 服务器 (Local DNS)。
- 原因:客户端(如你的电脑)通常只配置了 DNS 服务器地址,不具备自己去遍历全球 DNS 树的能力,所以全权委托给本地 DNS。
迭代查询 (Iterative Query):
- 含义:“告诉我下一步找谁”。如果被询问的服务器不知道,它会返回一个“能回答你问题的服务器”的 IP,让你自己去问。
- 发生场景:本地 DNS 服务器 根/TLD/权威 DNS 服务器。
- 原因:根服务器和顶级域服务器负载极高,如果它们都要负责帮别人“跑腿”查到底,很快就会瘫痪。所以它们只负责“指路”。
典型流程总结:
- 主机 本地 DNS:递归(帮我查
www.example.com)。 - 本地 DNS 根 DNS:迭代(根说:找
.com服务器,IP 是 x.x.x.x)。 - 本地 DNS .com DNS:迭代(.com 说:找
example.com服务器,IP 是 y.y.y.y)。 - 本地 DNS example.com DNS:迭代(权威说:IP 是 z.z.z.z)。
- 本地 DNS 主机:返回最终 IP z.z.z.z。
- 主机 本地 DNS:递归(帮我查
3. 常见 DNS 记录类型 #
| 类型 | 描述 | 示例 |
|---|---|---|
| A | 主机名 -> IPv4 地址 | example.com -> 93.184.216.34 |
| AAAA | 主机名 -> IPv6 地址 | example.com -> 2606:2800:220:1:248:1893:25c8:1946 |
| CNAME | 别名 -> 规范主机名 | www.example.com -> example.com |
| MX | 邮件交换记录 | example.com -> mail.example.com (优先级 10) |
| NS | 域名服务器记录 | example.com -> ns1.example.com |
4. 协议细节 #
- 端口:53。
- 传输层:
- UDP:绝大多数查询使用 UDP(效率高,头部开销小)。限制 512 字节(EDNS 可扩展)。
- TCP:用于区域传送 (Zone Transfer)(主从服务器同步)或响应超过 512 字节时。
电子邮件 (Email) #
- SMTP (Simple Mail Transfer Protocol):推 (Push) 协议。用于用户代理向邮件服务器发送邮件,以及邮件服务器之间的转发。TCP 25。
- POP3 (Post Office Protocol v3):拉 (Pull) 协议。用户从服务器下载邮件,默认下载后删除(虽可配置保留)。TCP 110。
- IMAP (Internet Message Access Protocol):拉 (Pull) 协议。用户在服务器上管理邮件(文件夹、状态同步),适合多端访问。TCP 143。
P2P 文件分发 (Peer-to-Peer) #
- C/S 架构 vs P2P 架构分发时间对比:
设文件大小为 ,用户数为 ,服务器上传能力 ,第 个用户的上传/下载能力为 ,最小下载能力 。
- C/S 架构: 随着 增加,分发时间线性增长。
- P2P 架构: 具有自扩展性 (Self-scalability)。当 很大时,分子分母都含 ,分发时间趋于常数。
BitTorrent 协议详解 #
BitTorrent 是最流行的 P2P 文件分发协议,其核心理念是 “人人为我,我为人人”。
1. 基本术语 #
- Torrent (种子):包含元数据(文件名、长度、Tracker 地址等)的文件。
- Tracker (追踪器):一台服务器,负责记录当前正在下载/上传该文件的所有 Peer 的 IP 和端口。它不存储文件本身。
- Peer (对等方):参与文件分发的普通计算机。
- Leecher (吸血鬼/下载者):拥有部分文件,正在下载剩余部分。
- Seeder (种子/做种者):拥有完整文件,只上传不下载。
- Chunk (块):文件被划分为固定大小(通常 256KB)的块。
2. 工作流程 #
- 加入:新 Peer A 读取 .torrent 文件,连接 Tracker,获取一个 Peer 列表(例如 50 个邻居)。
- 建立连接:A 与这些邻居建立 TCP 连接。
- 交换位图 (Bitmap):每个 Peer 告诉邻居自己有哪些块。
- 请求与传输:A 根据策略向邻居请求自己没有的块。
3. 核心策略 #
BitTorrent 的高效主要归功于以下两个策略:
A. 块选择策略:最稀有优先 (Rarest First)
- 问题:我应该先请求哪个块?
- 策略:优先请求在邻居中副本最少的块。
- 目的:
- 防止丢失:稀有块最容易因为拥有者下线而绝种,必须尽快复制。
- 促进交换:拿到稀有块后,我就成了“香饽饽”,别人都会来找我交换,增加了我的上传机会(进而增加下载机会)。
B. 邻居选择策略:以牙还牙 (Tit-for-Tat)
- 问题:我应该把有限的上传带宽分给谁?
- 机制 (Choking Algorithm):
- 疏通 (Unchoked):A 测量从邻居接收数据的速率,选择最快的前 4 位,向他们提供上传服务。每 10 秒重新评估一次。
- 阻塞 (Choked):其他邻居被阻塞,无法从 A 下载数据。
- 乐观疏通 (Optimistic Unchoking):每 30 秒,A 随机选择一个被阻塞的邻居进行疏通。
- 目的:寻找可能比当前前 4 位更快的潜在优质邻居(探索机制)。
- 效果:如果新邻居回馈速度快,它就会在下一次评估中晋升为前 4 位。
综合案例:当你在浏览器输入 URL 时发生了什么? #
这是一个经典的面试题,也是串联计算机网络各层协议的最佳案例。假设你打开电脑,连接 WiFi,在浏览器输入 http://www.google.com 并回车。
1. 准备阶段:接入网络 (DHCP & ARP) #
如果你的电脑刚连上网络,还没有 IP 地址:
- DHCP (应用层/UDP):电脑广播
DHCP Discover报文。 - DHCP Server(通常是路由器)回复
DHCP Offer,分配 本机 IP、子网掩码、默认网关 IP 和 DNS 服务器 IP。 - ARP (链路层):电脑现在有了网关 IP,但要发包出去需要网关的 MAC 地址。
- 电脑广播
ARP Request:“谁是 192.168.1.1?” - 网关回复
ARP Reply:“我是,MAC 是 xx:xx…”。
- 电脑广播
2. 名字解析:找 IP (DNS) #
浏览器不知道 www.google.com 在哪,需要 IP 地址。
- 查询缓存:浏览器缓存 操作系统缓存 (hosts) 路由器缓存。
- DNS 查询 (应用层/UDP):若缓存未命中,向 本地 DNS 服务器 发送查询请求。
- 迭代/递归:本地 DNS 依次询问根、.com、google.com 权威服务器,最终获得
www.google.com的 IP 地址。
3. 建立连接:三次握手 (TCP) #
拿到目标 IP 后,浏览器准备发送 HTTP 请求,但 HTTP 基于 TCP,需先建立连接。
- 封装:TCP 头部 (SYN=1, Seq=x) IP 头部 (源/目 IP) MAC 头部 (源 MAC/网关 MAC)。
- 握手流程:
- Client 发送 SYN。
- Server 回复 SYN+ACK。
- Client 发送 ACK。
- 注:此时连接建立,双方确认了初始序列号和窗口大小。
4. 数据传输:发送请求与响应 (HTTP) #
- 发送请求:浏览器构建
HTTP GET / HTTP/1.1请求报文。 - 传输:报文被 TCP 分段,IP 分片,通过网关转发,经过互联网上的多个路由器(OSPF/BGP 决定路径),最终到达 Google 服务器。
- 服务器处理:Google 服务器收到包,解析 HTTP 请求,处理业务逻辑,构建
HTTP 200 OK响应报文(包含 HTML 内容)。 - 接收响应:响应报文回传给浏览器。
5. 页面渲染与资源加载 #
- 解析:浏览器解析 HTML,构建 DOM 树。
- 子资源加载:解析过程中发现 CSS、JS、图片等链接,重复上述步骤(DNS可能缓存,TCP可能复用 Keep-Alive)下载这些资源。
- 渲染:结合 DOM 树和 CSSOM 树,绘制页面。
6. 断开连接:四次挥手 (TCP) #
若 HTTP 头部 Connection: close 或页面关闭,触发 TCP 四次挥手释放连接资源。