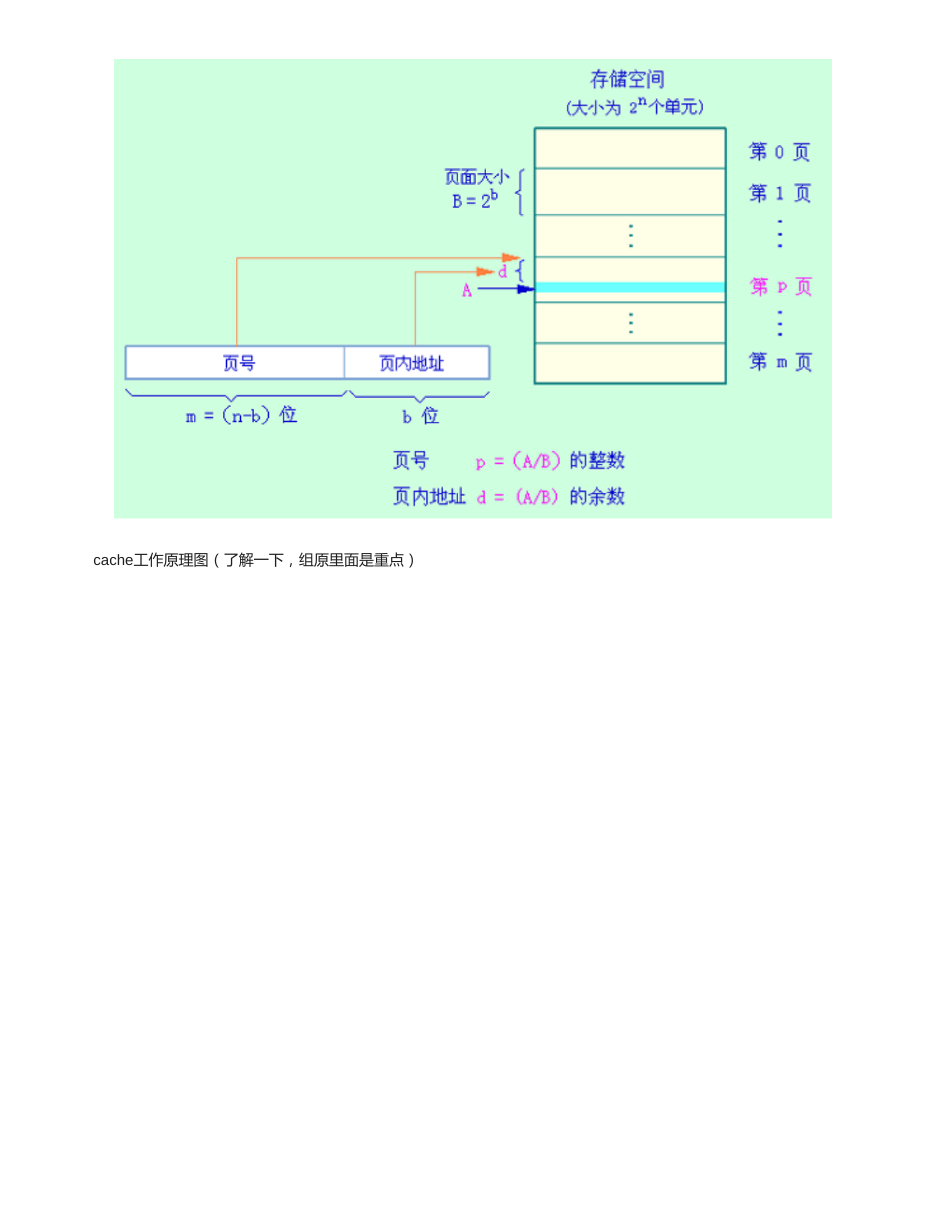
先看主线,再背公式,最后做题
每个专题页都按“概念框架、公式变量、典型题型、原讲义对照、自测问题”组织。复习时从左侧目录跳转,遇到计算题直接回到高亮公式段。
本章内容最多,建议用一条线串起来:为什么要层次化存储,Cache 四问怎么回答,性能公式怎么套,最后主存带宽怎么优化。
每个专题页都按“概念框架、公式变量、典型题型、原讲义对照、自测问题”组织。复习时从左侧目录跳转,遇到计算题直接回到高亮公式段。
41 页原讲义截图可展开核对,适合考前查原表、原图和例题。
正文已经把知识点重新组织;这里保留讲义页面缩略图,方便你在需要时回看原版题目、图和表。
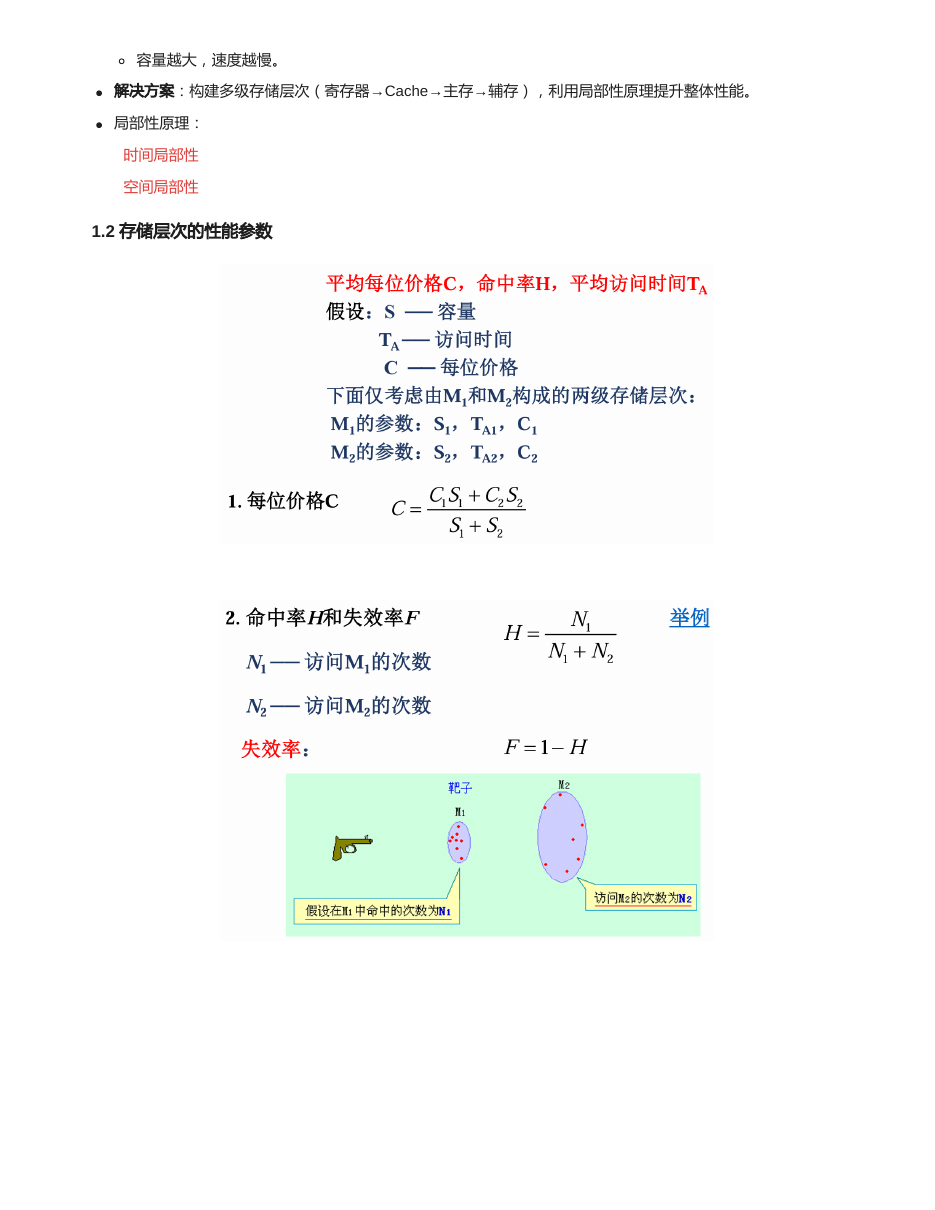
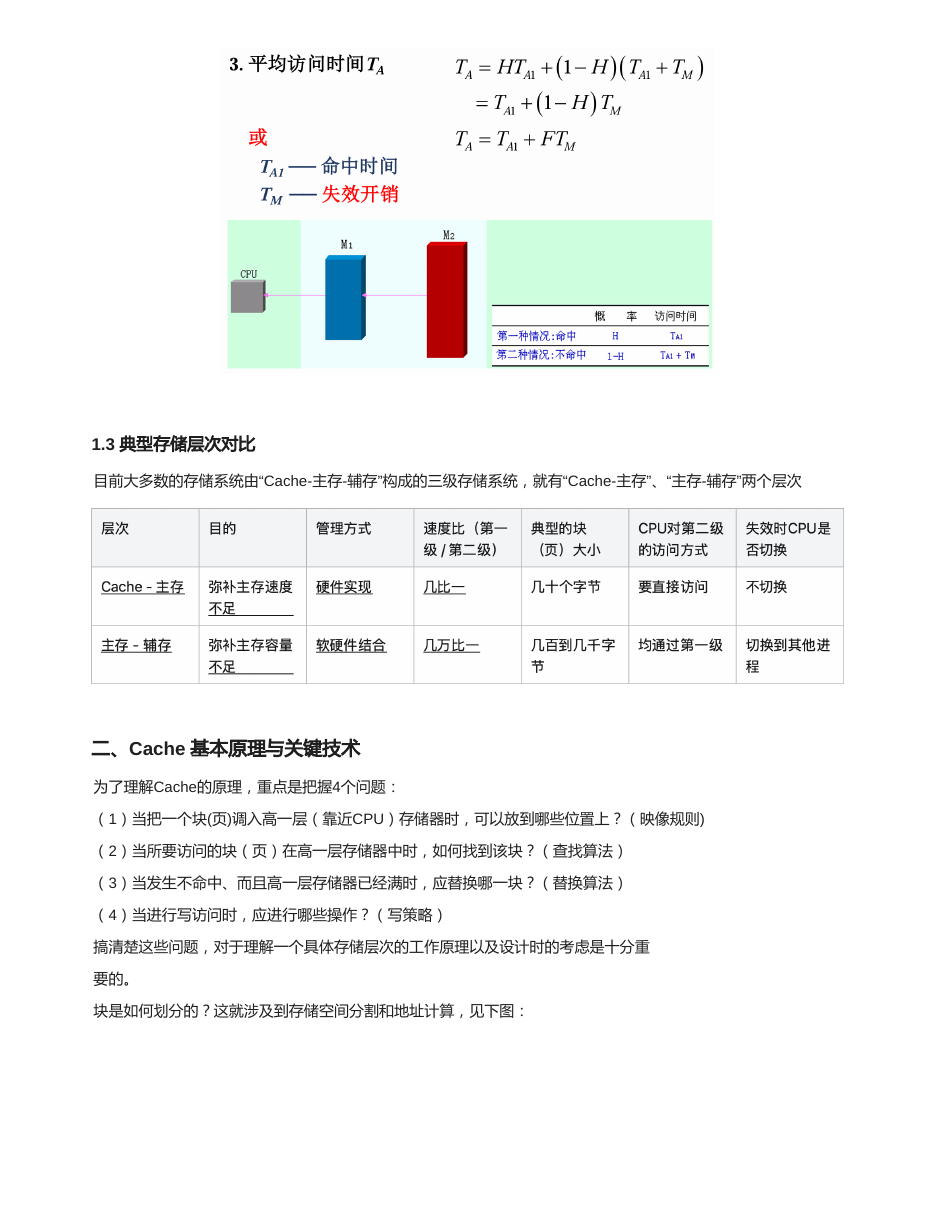
理想存储器希望容量大、速度快、价格低,但现实中三者互相制约。层次化存储用小而快的上层存储保存热点数据,用大而慢的下层存储提供容量。
刚访问过的数据或指令,不久后很可能再次访问。
访问某地址后,很可能继续访问附近地址。
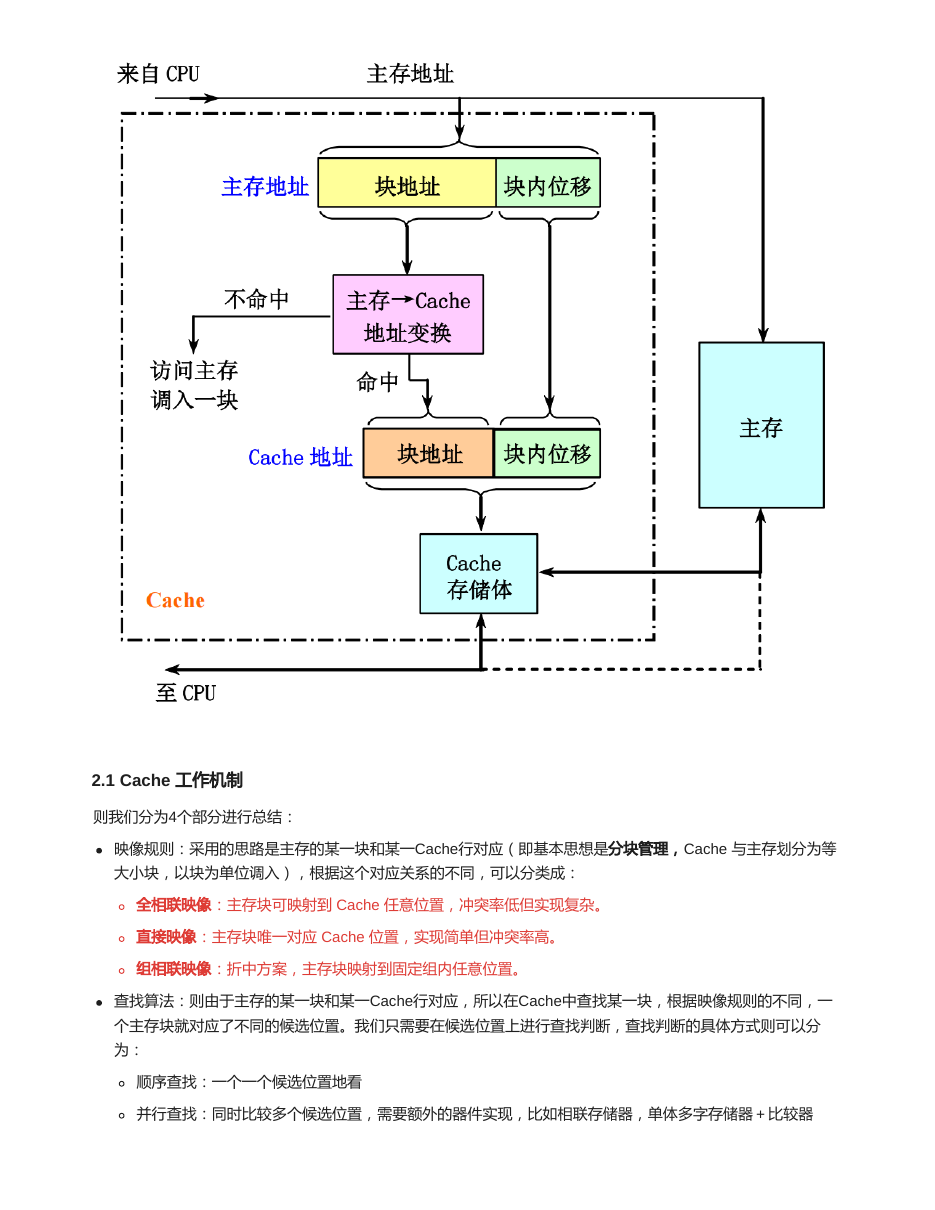
Cache 和主存通常按块交换数据,正是为了利用空间局部性。
| 问题 | 名称 | 常见答案 |
|---|---|---|
| 主存块调入 Cache 时放哪里? | 映像规则 | 直接映像、全相联映像、组相联映像。 |
| 访问时怎么找到目标块? | 查找算法 | 在候选位置比较标记,可顺序或并行查找。 |
| Cache 满了替换哪块? | 替换算法 | 随机、FIFO、LRU。 |
| 写访问怎么处理? | 写策略 | 写直达、写回;按写分配、不按写分配。 |
| 映像方式 | 优点 | 缺点 | 地址直觉 |
|---|---|---|---|
| 直接映像 | 硬件简单、命中时间短。 | 冲突失效率高。 | 块号对 Cache 行数取模得到行号。 |
| 全相联映像 | 冲突少,替换灵活。 | 需要比较所有标记,硬件复杂。 | 没有固定索引,主要靠标记比较。 |
| 组相联映像 | 折中方案。 | 相联度提高会增加比较器和命中时间。 | 先定位组,再在组内比较路。 |
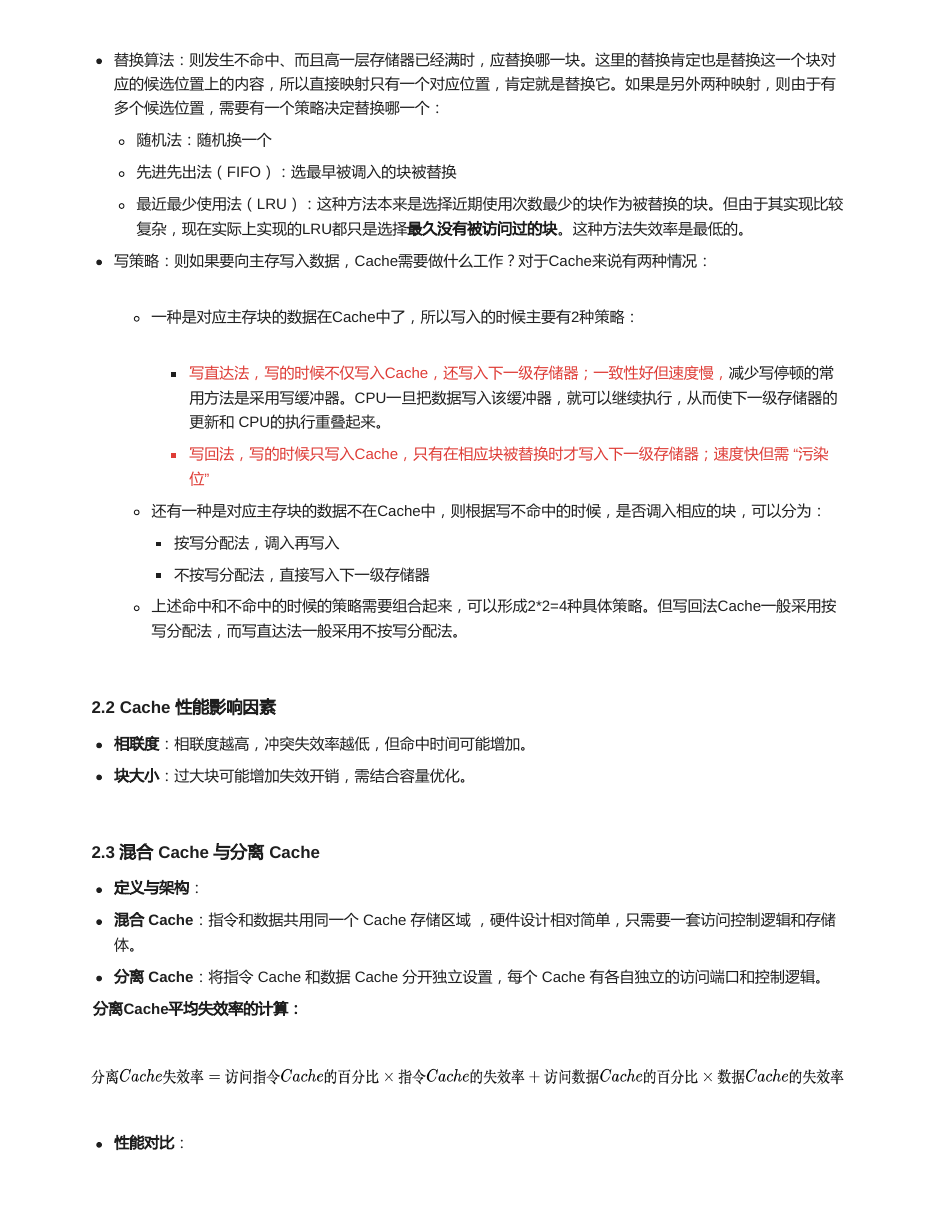
写直达一致性好但写流量大,可用写缓冲器减少 CPU 等待;写回速度快但需要污染位,替换脏块时才写回下一级。
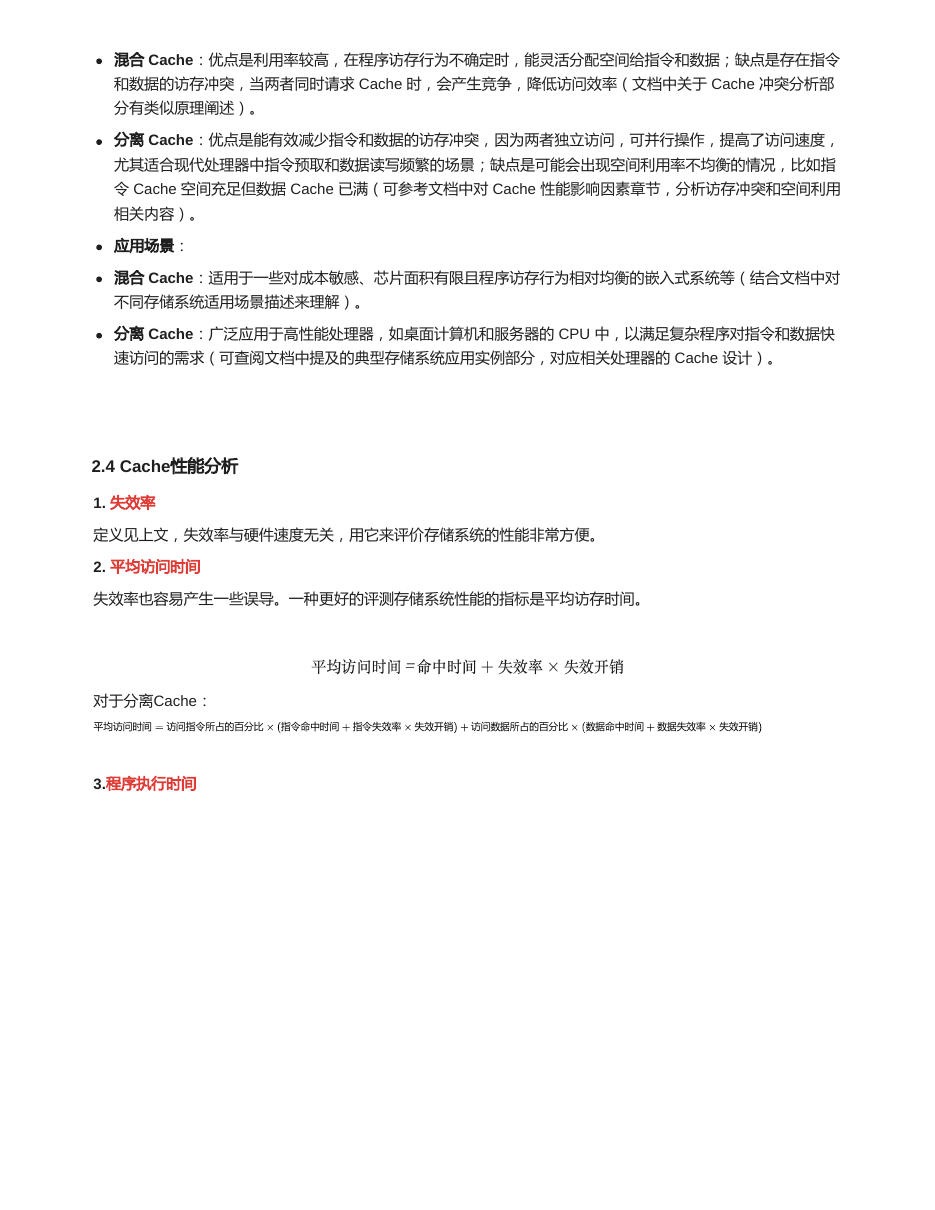
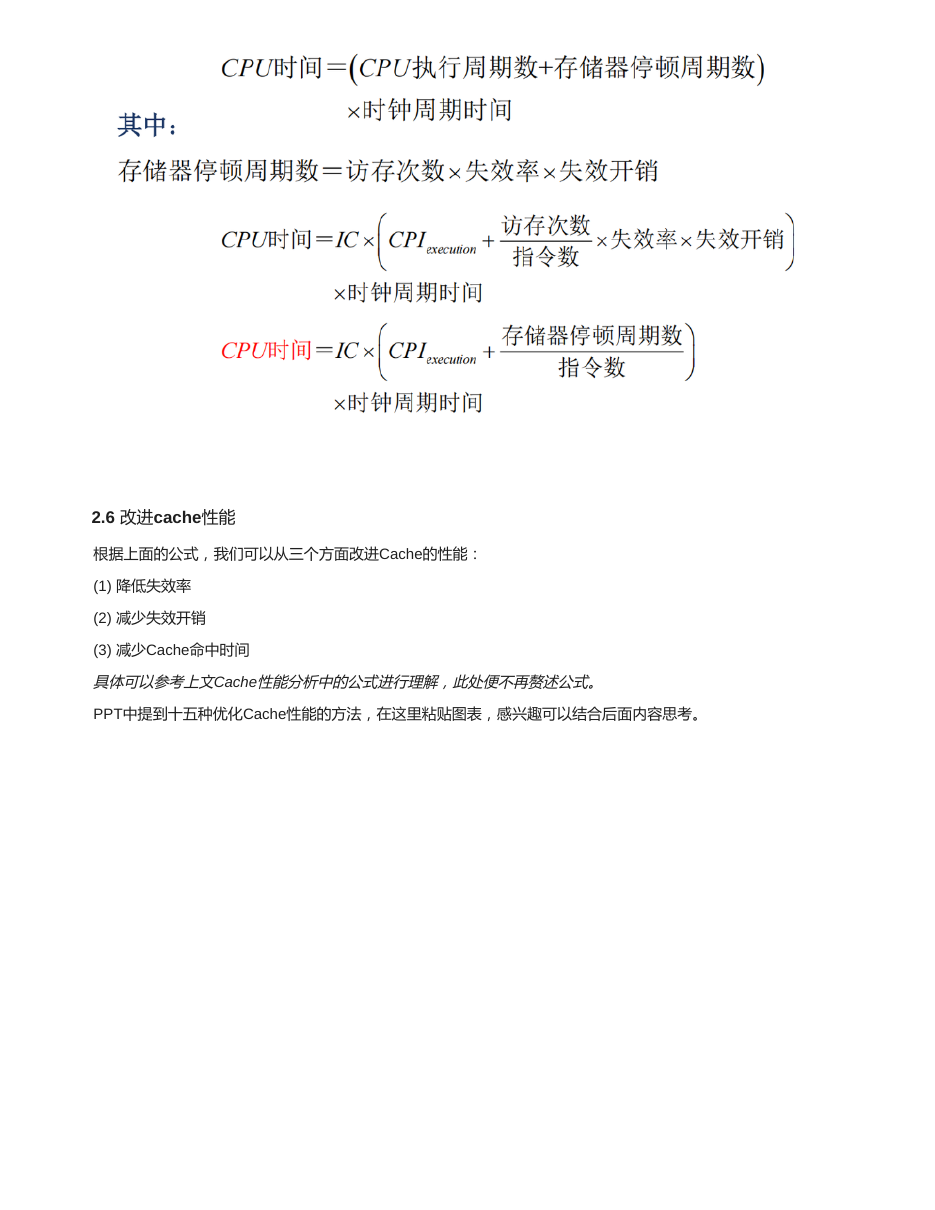
平均访问时间衡量存储访问本身,但最终比较系统性能时常常要回到 CPU 时间。
| 结构 | 含义 | 优点 | 缺点 |
|---|---|---|---|
| 混合 Cache | 指令和数据共用同一个 Cache。 | 空间利用更灵活,硬件相对简单。 | 取指和访数据可能争用同一 Cache 端口。 |
| 分离 Cache | 指令 Cache 和数据 Cache 分开。 | 取指和访数据可并行,减少结构冲突。 | 可能出现指令 Cache 空闲而数据 Cache 紧张的空间不均衡。 |
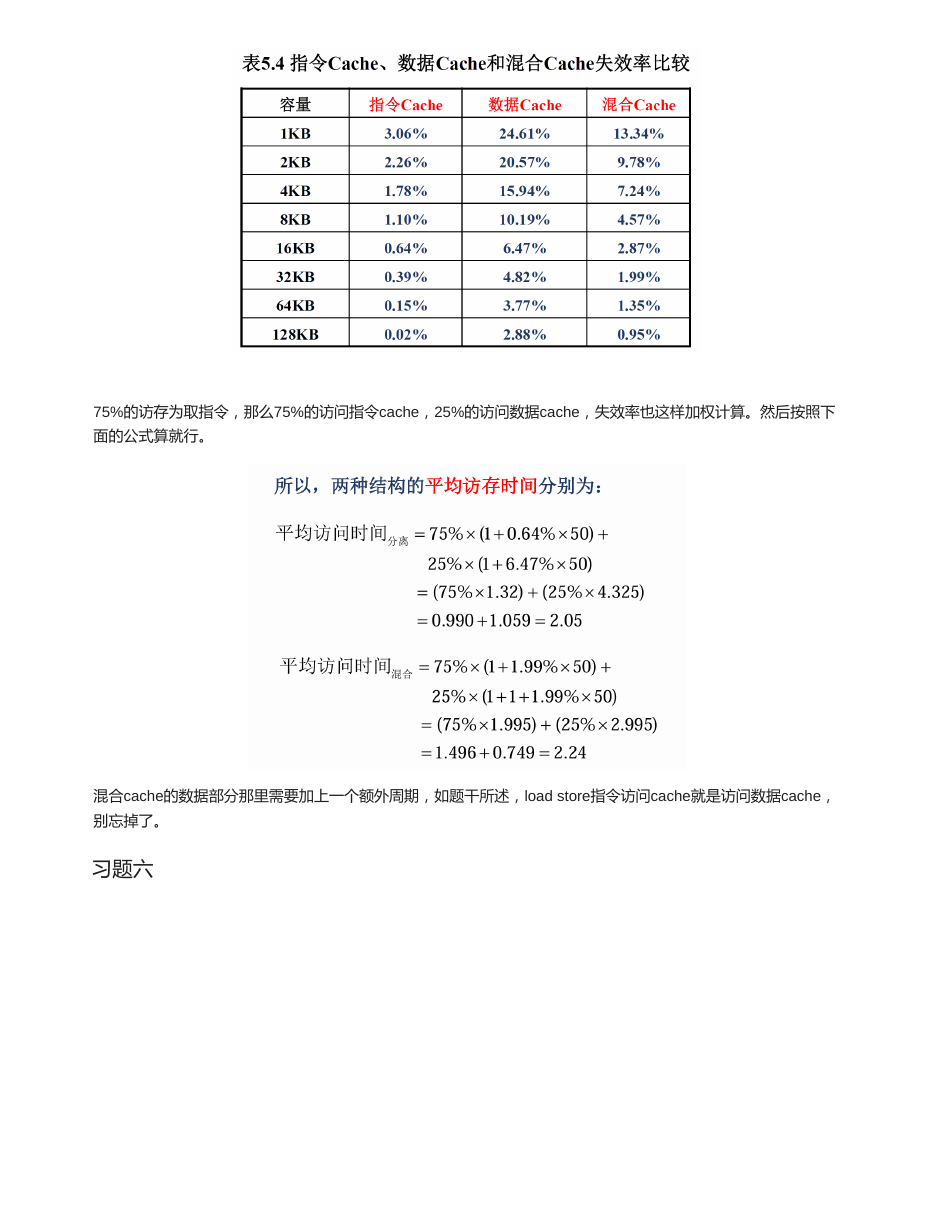
题目若给“75% 访存为取指,25% 为数据访问”,就按比例加权计算分离 Cache 的平均失效率或平均访问时间。
| 失效类型 | 原因 | 优化思路 |
|---|---|---|
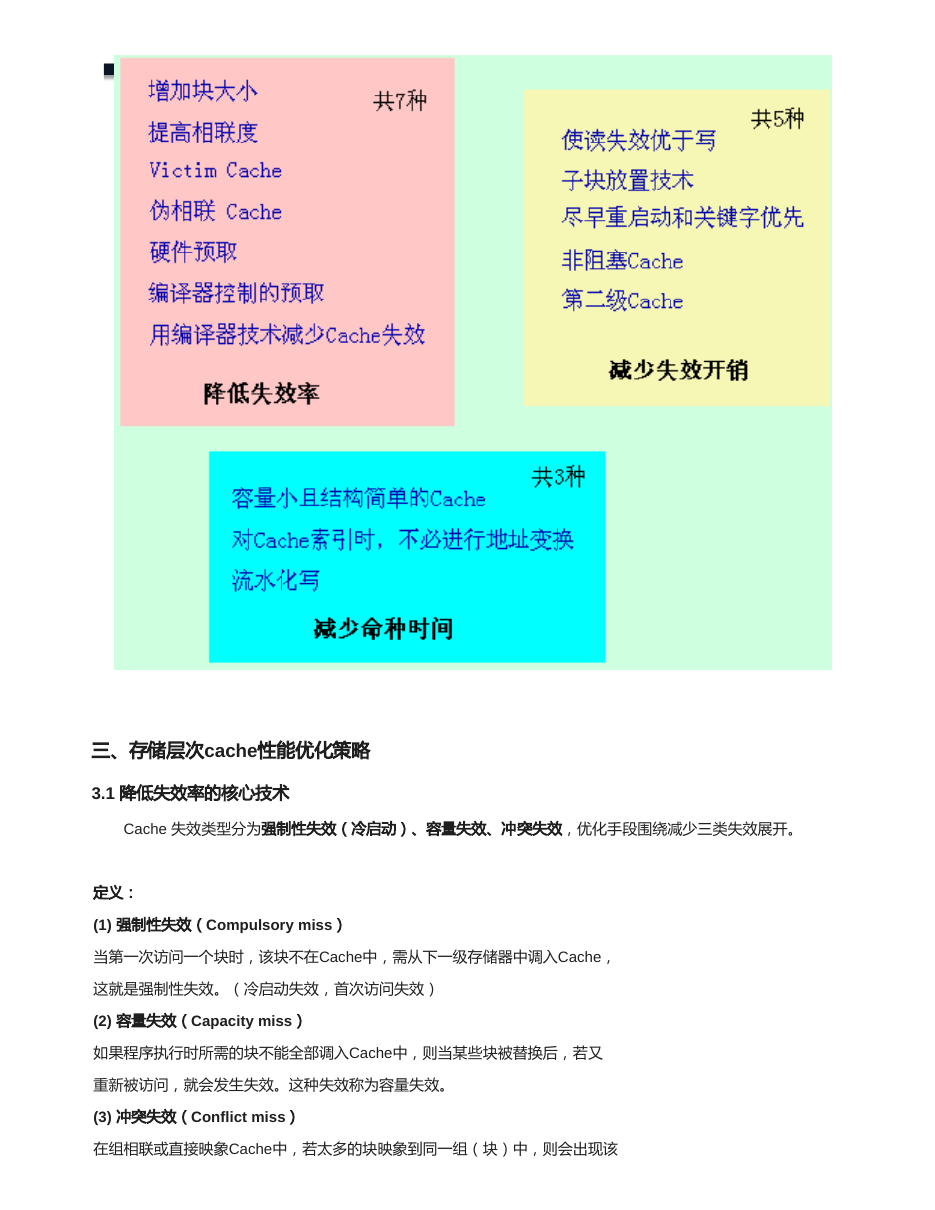
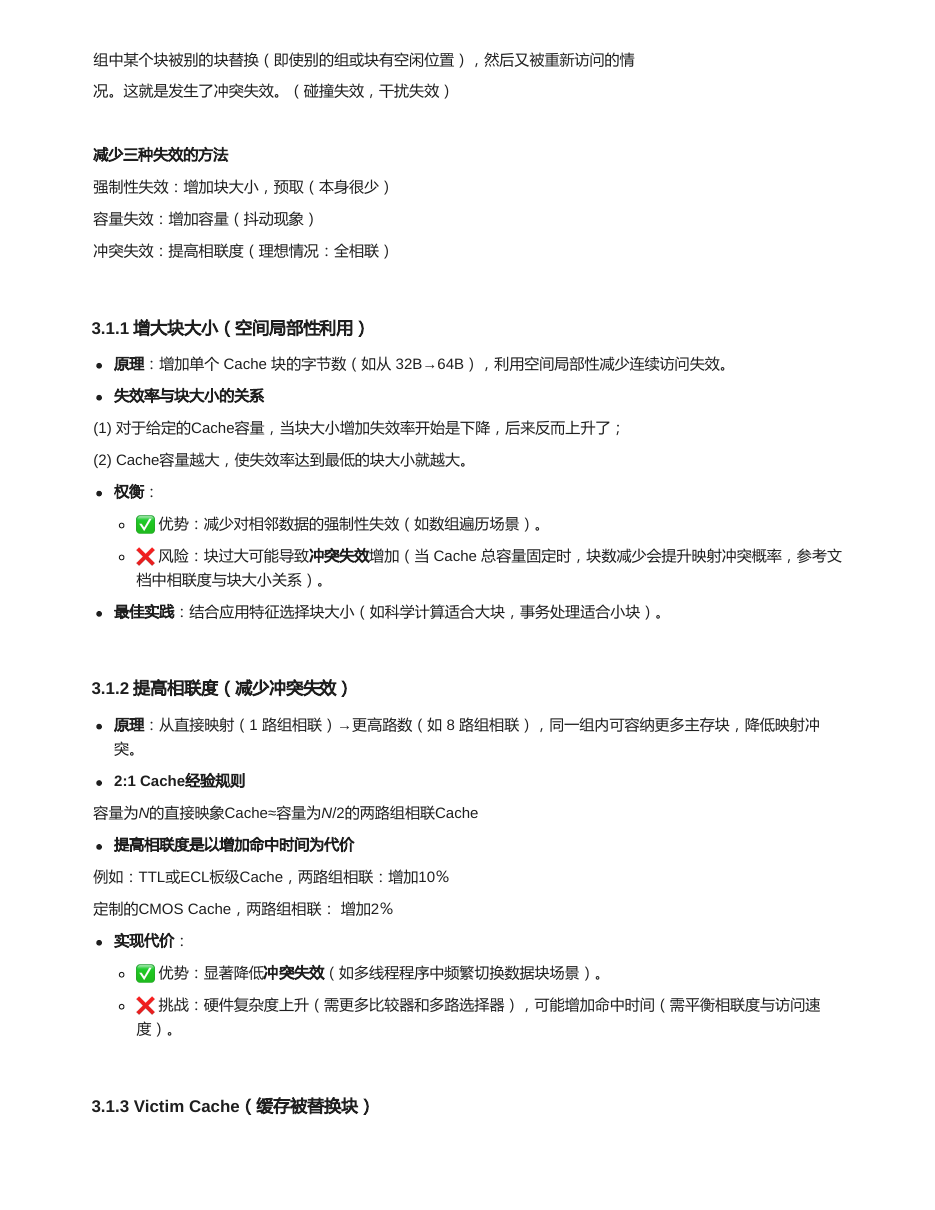
| 强制性失效 | 第一次访问某块,Cache 中一定没有。 | 增大块大小、预取。 |
| 容量失效 | 工作集大于 Cache 容量,块被换出后又访问。 | 增加 Cache 容量,改善程序局部性。 |
| 冲突失效 | 多个常用块映射到同一组或同一行。 | 提高相联度、Victim Cache、伪相联 Cache。 |
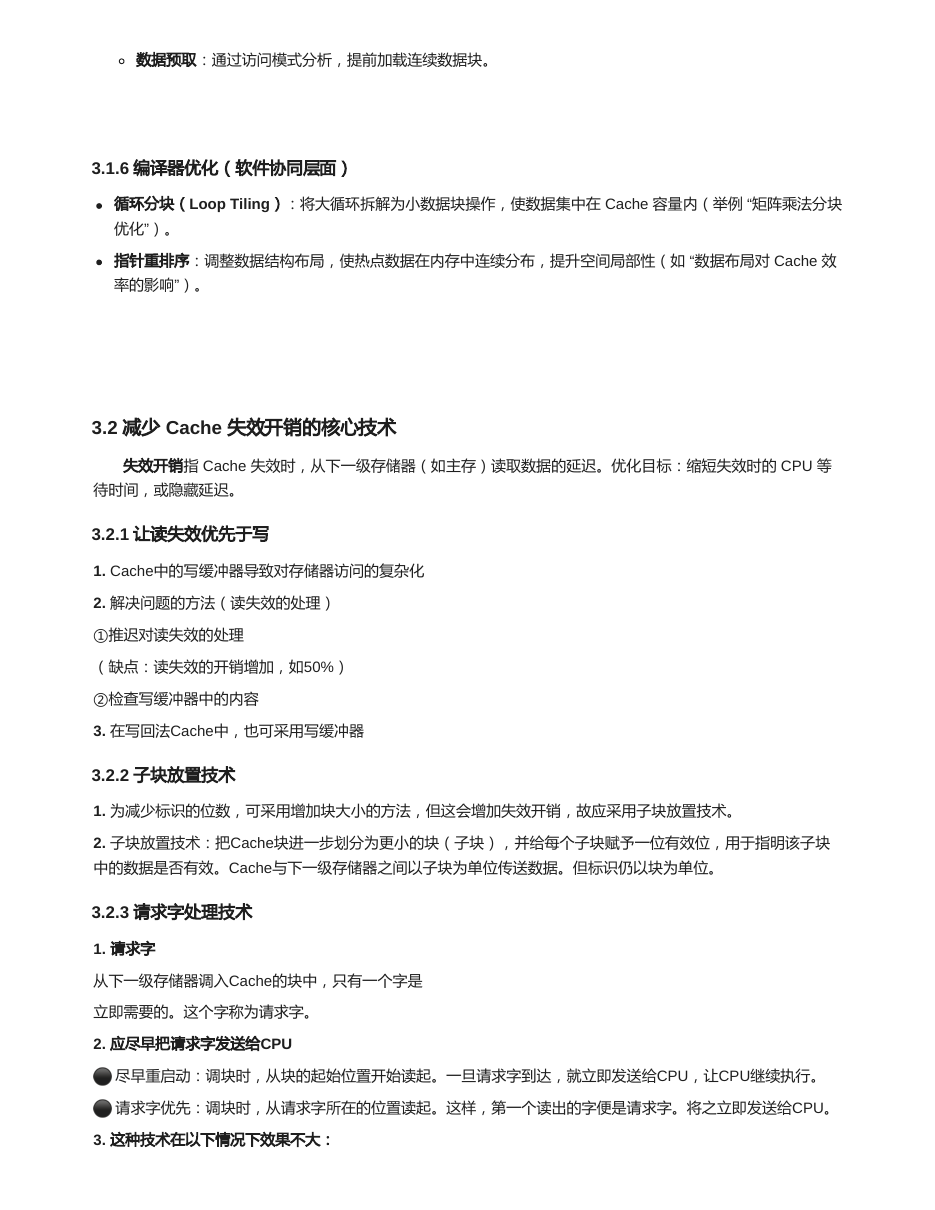
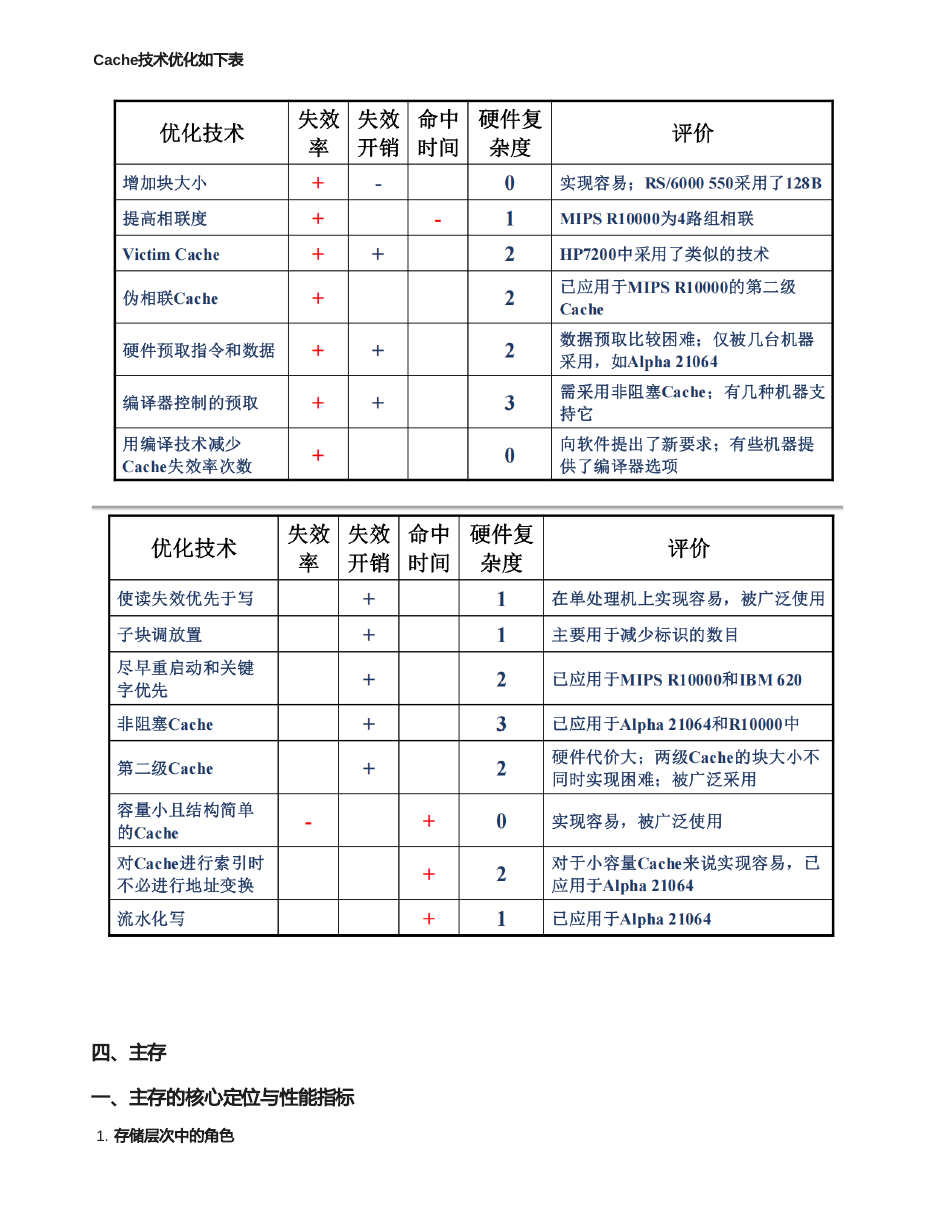
检查写缓冲器,避免读请求被等待写回拖慢。
标记仍按大块,传送按子块,减少失效开销。
先把 CPU 立即需要的字送回来,让 CPU 尽快继续执行。
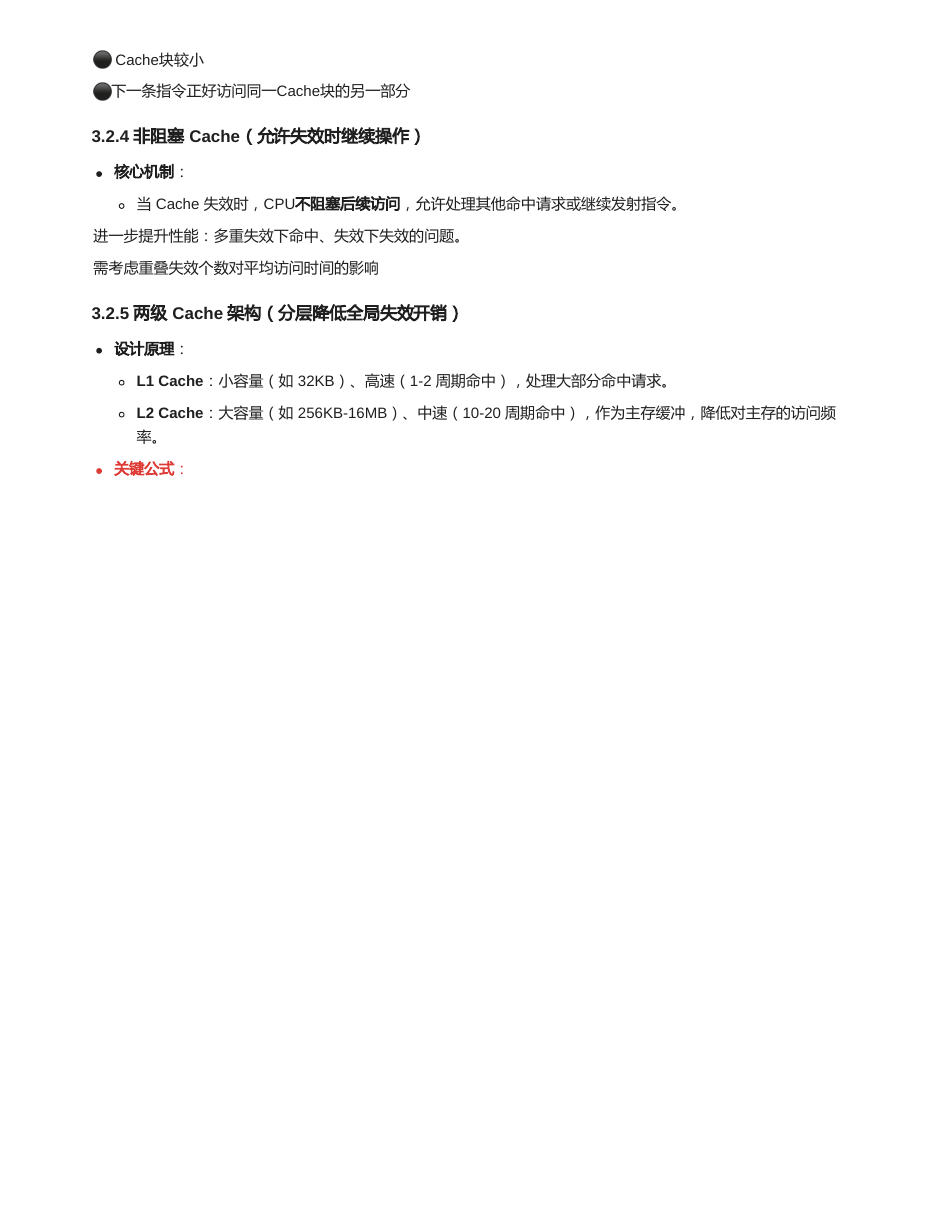
Cache miss 时允许后续命中继续处理,隐藏部分等待。
减少命中时间的核心是小而简单:L1 Cache 容量不宜过大,结构不宜过复杂,否则可能限制处理器时钟频率。
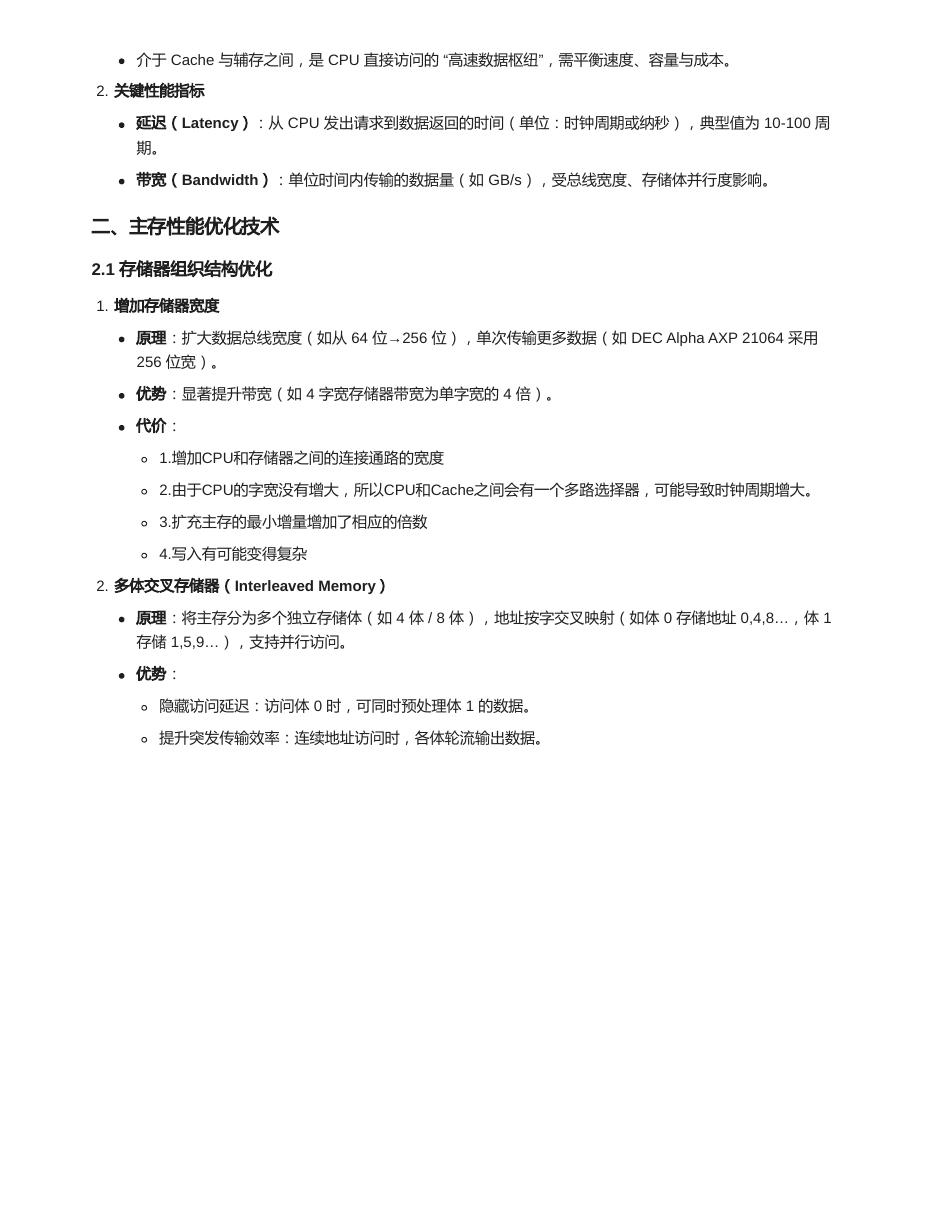
主存位于 Cache 和辅存之间,性能主要看延迟和带宽。Cache 不命中开销常常由送地址、访问时间、数据传输时间构成。
| 技术 | 作用 | 题目里的体现 |
|---|---|---|
| 增加存储器宽度 | 一次传更多数据,提高带宽。 | 同一 Cache 块需要的传输次数减少。 |
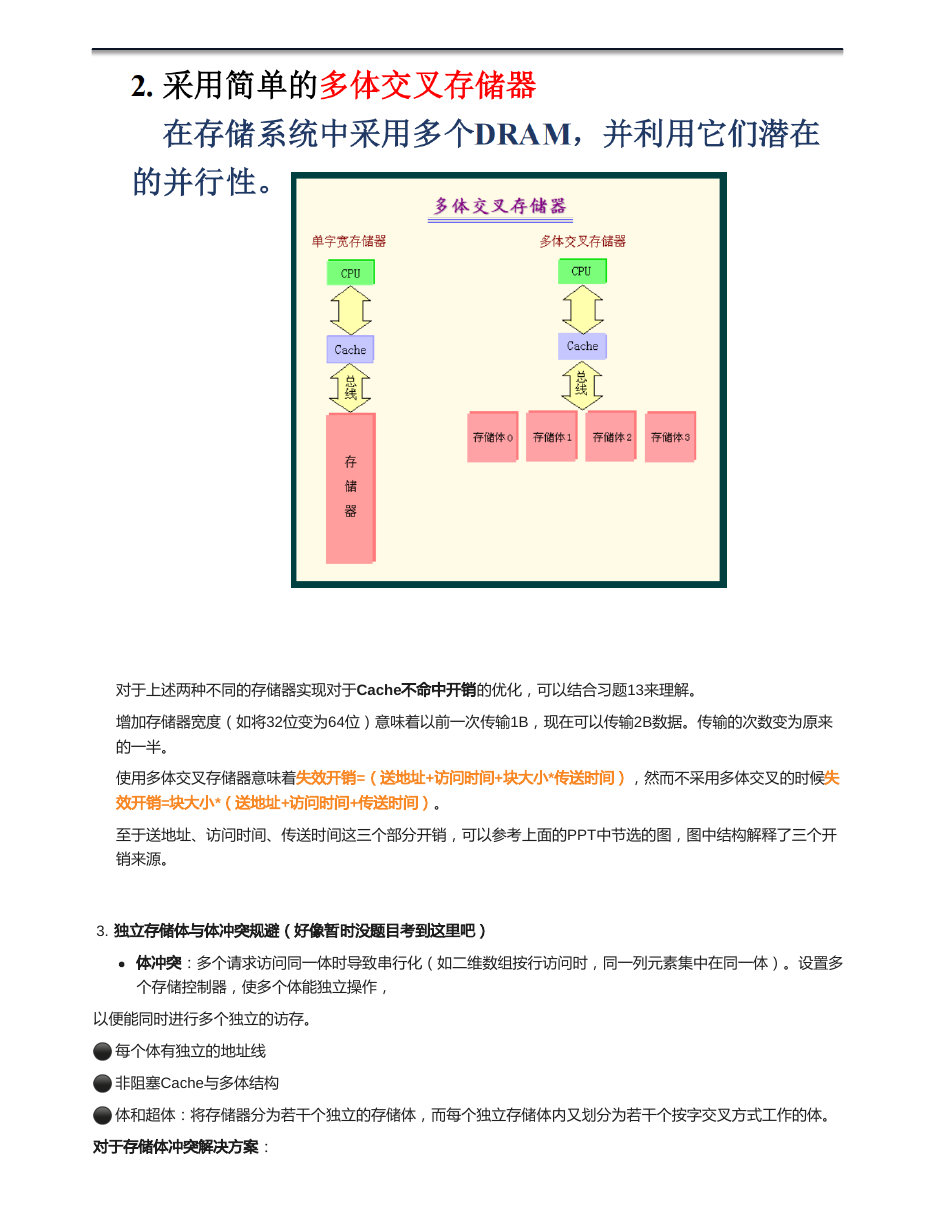
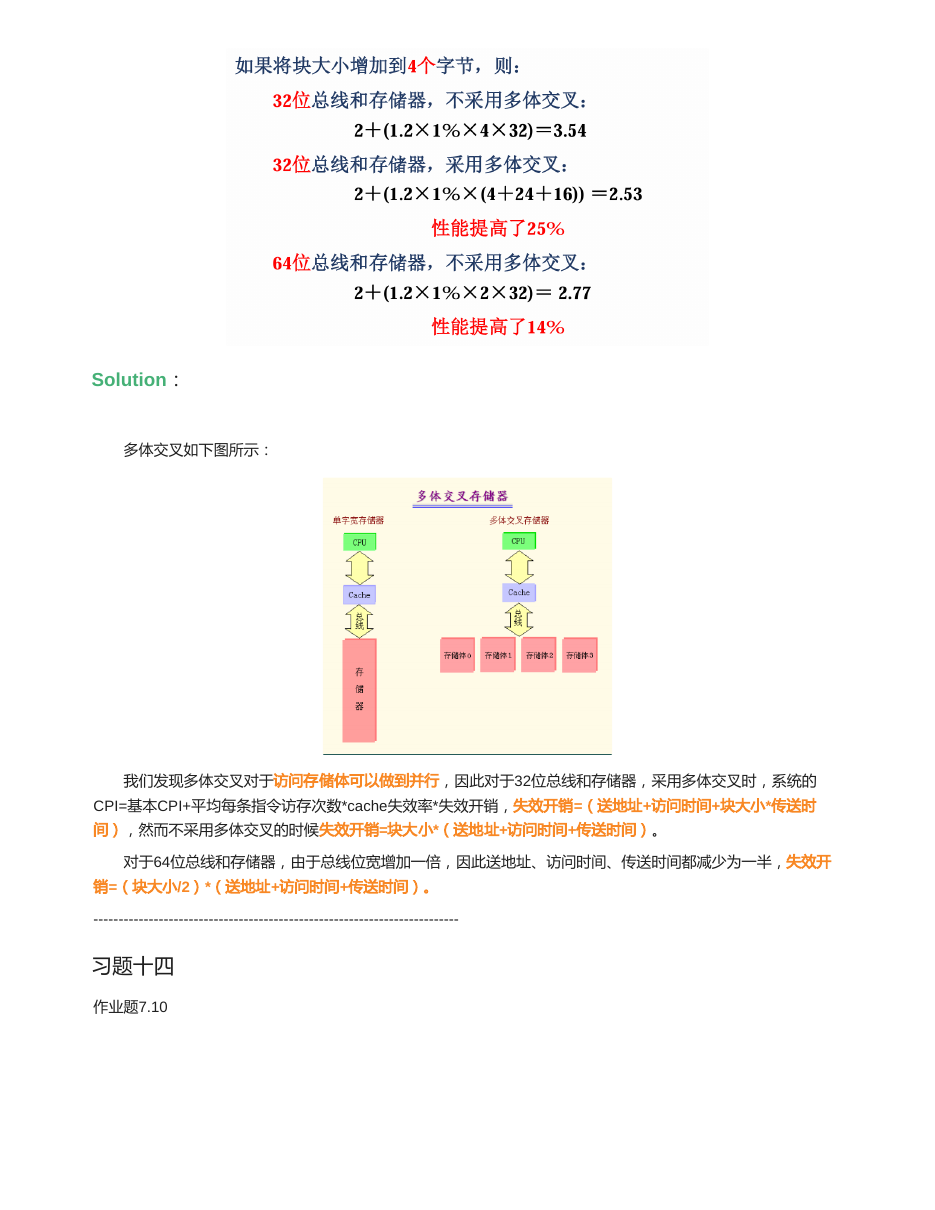
| 多体交叉存储器 | 连续地址分布在不同存储体,可并行访问。 | 失效开销可写成送地址 + 访问时间 + 块大小 × 传送时间。 |
| 独立存储体 | 多个体各自有控制线路,支持多个独立访存。 | 要注意体冲突和地址映射。 |
| 题型 | 公式 | 变量提醒 |
|---|---|---|
| 地址拆分 | 块内偏移 = log2(块大小);组索引 = log2(组数);标记 = 地址位数 - 组索引 - 块内偏移 | 块大小通常按 Byte 算,注意字地址/字节地址。 |
| 平均访存时间 | AMAT = 命中时间 + 失效率 x 失效开销 | 失效率用小数,不要把百分数直接代入。 |
| 分离 Cache | AMAT = Pi(Hi + MRiPi) + Pd(Hd + MRdPd) | Pi/Pd 是指令/数据访问比例。 |
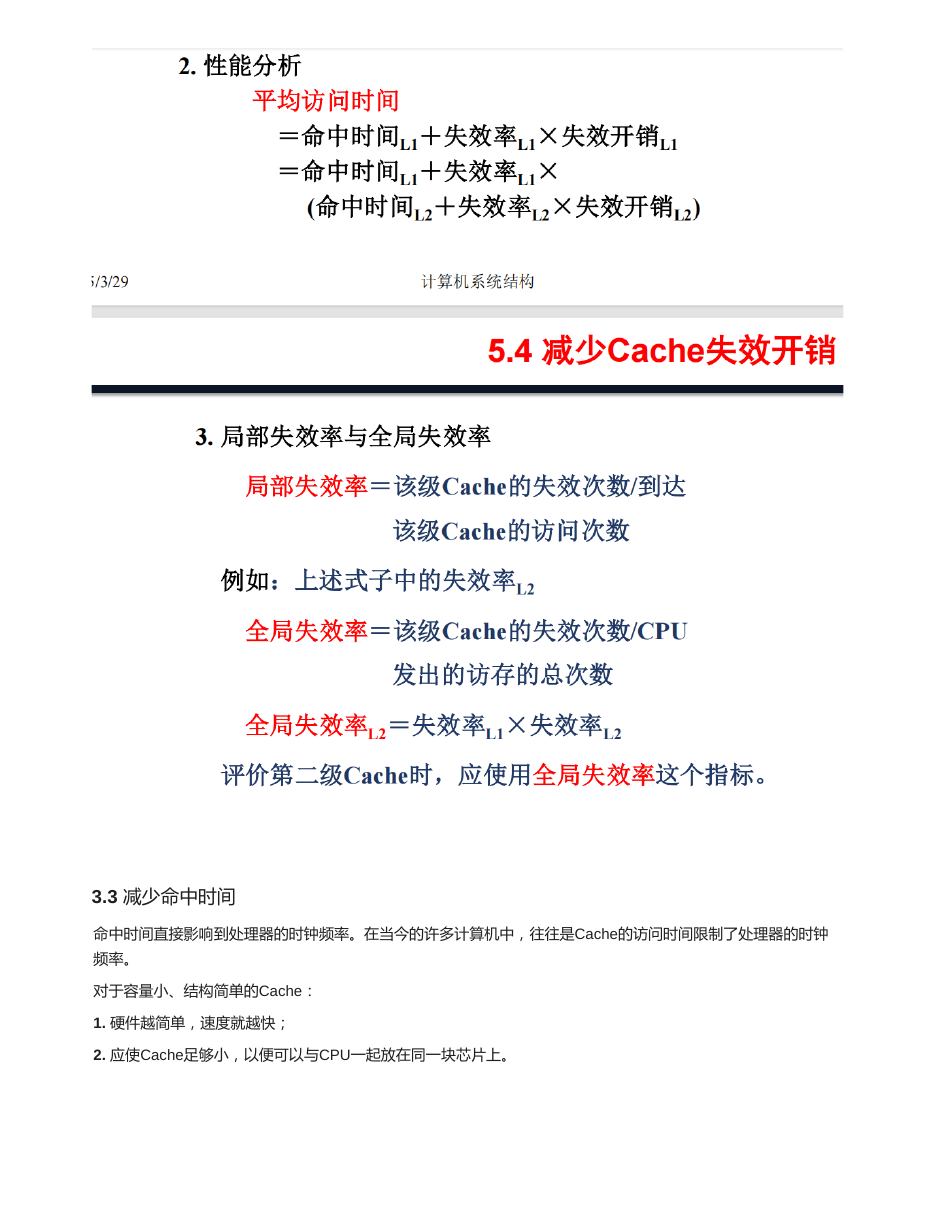
| 两级 Cache | AMAT = H1 + MR1(H2 + MR2P2) | MR2 是 L2 局部失效率,若题目给全局失效率要先换算。 |
| 存储器停顿 | 停顿周期/指令 = 访存次数/指令 x 失效率 x 失效开销 | 取指本身也算访存,Load/Store 还会增加数据访存。 |
| CPU 时间 | CPU 时间 = IC x (基础 CPI + 存储停顿周期/指令) x 时钟周期 | 比较系统性能时最终回到 CPU 时间。 |
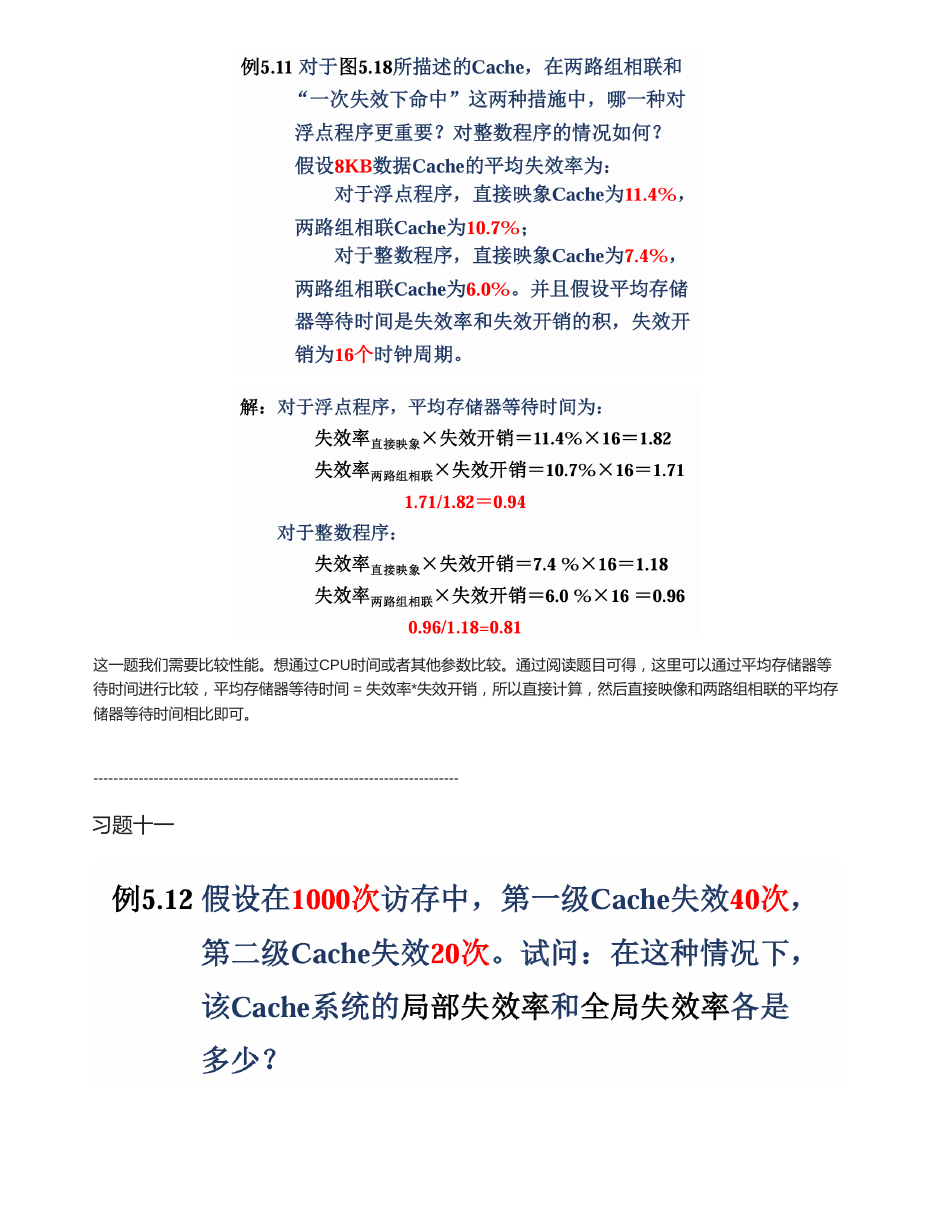
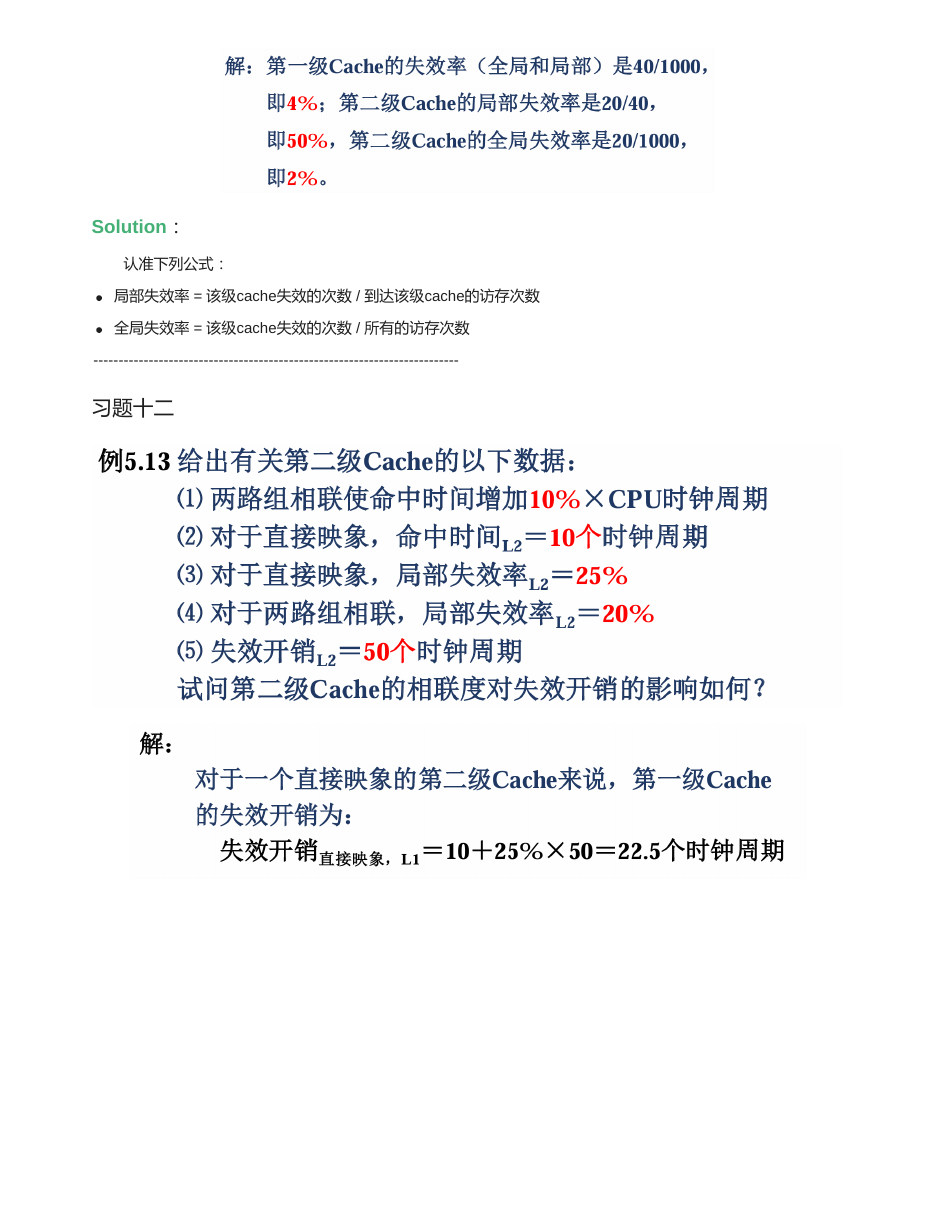
评价第二级 Cache 时,更应该看全局失效率;计算 L1 失效开销时,用 L2 局部失效率。
例:L1 访问 1000 次失效 40 次,L2 失效 20 次,则 L1 失效率 = 40/1000 = 4%,L2 局部失效率 = 20/40 = 50%,L2 全局失效率 = 20/1000 = 2%。
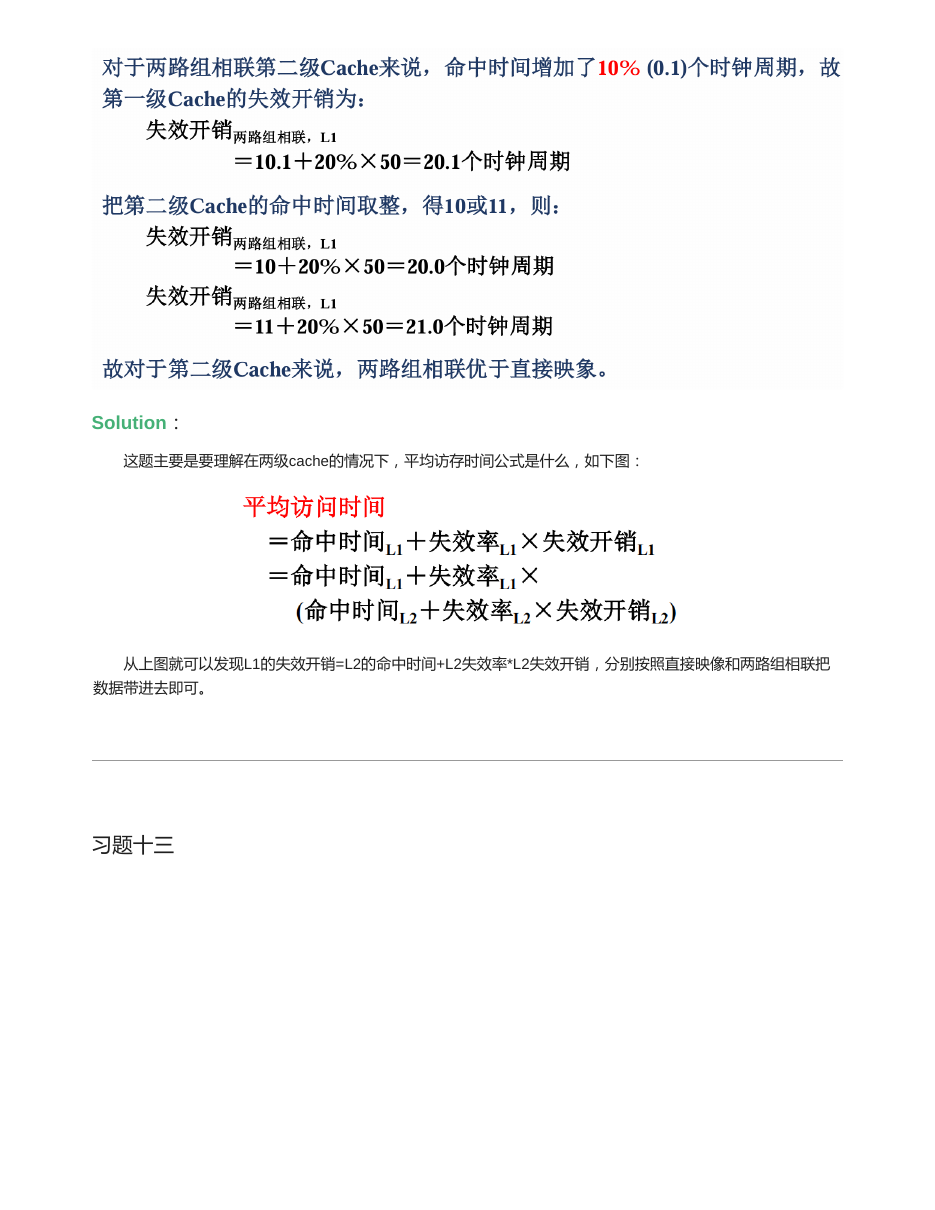
资料习题中直接映像 L2:H2 = 10 周期,MR2 = 25%,P2 = 50 周期。
两路组相联 L2:局部失效率降到 20%,但命中时间增加 0.1 个 CPU 周期。
结论:要同时看命中时间增加和失效率下降,不能只看其中一个。
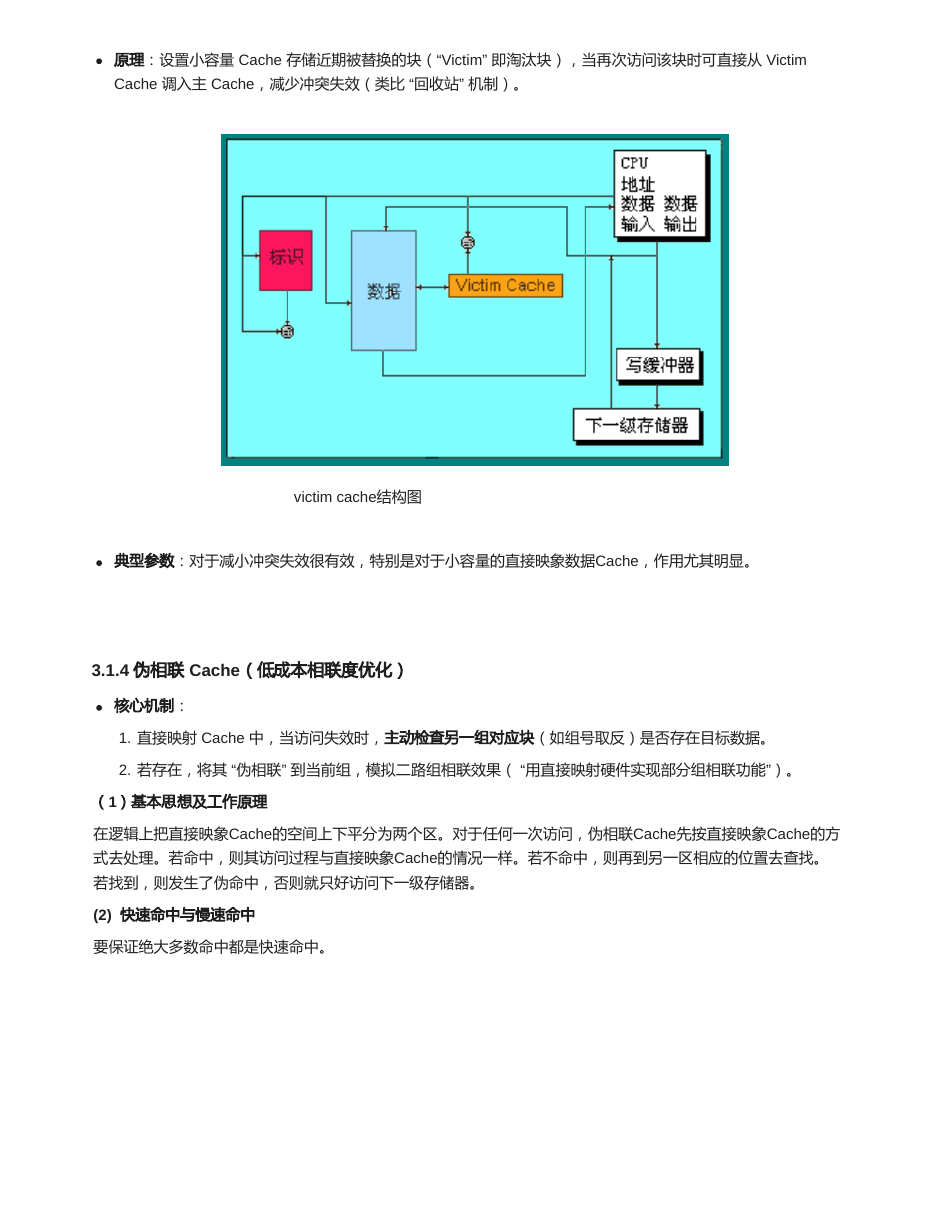
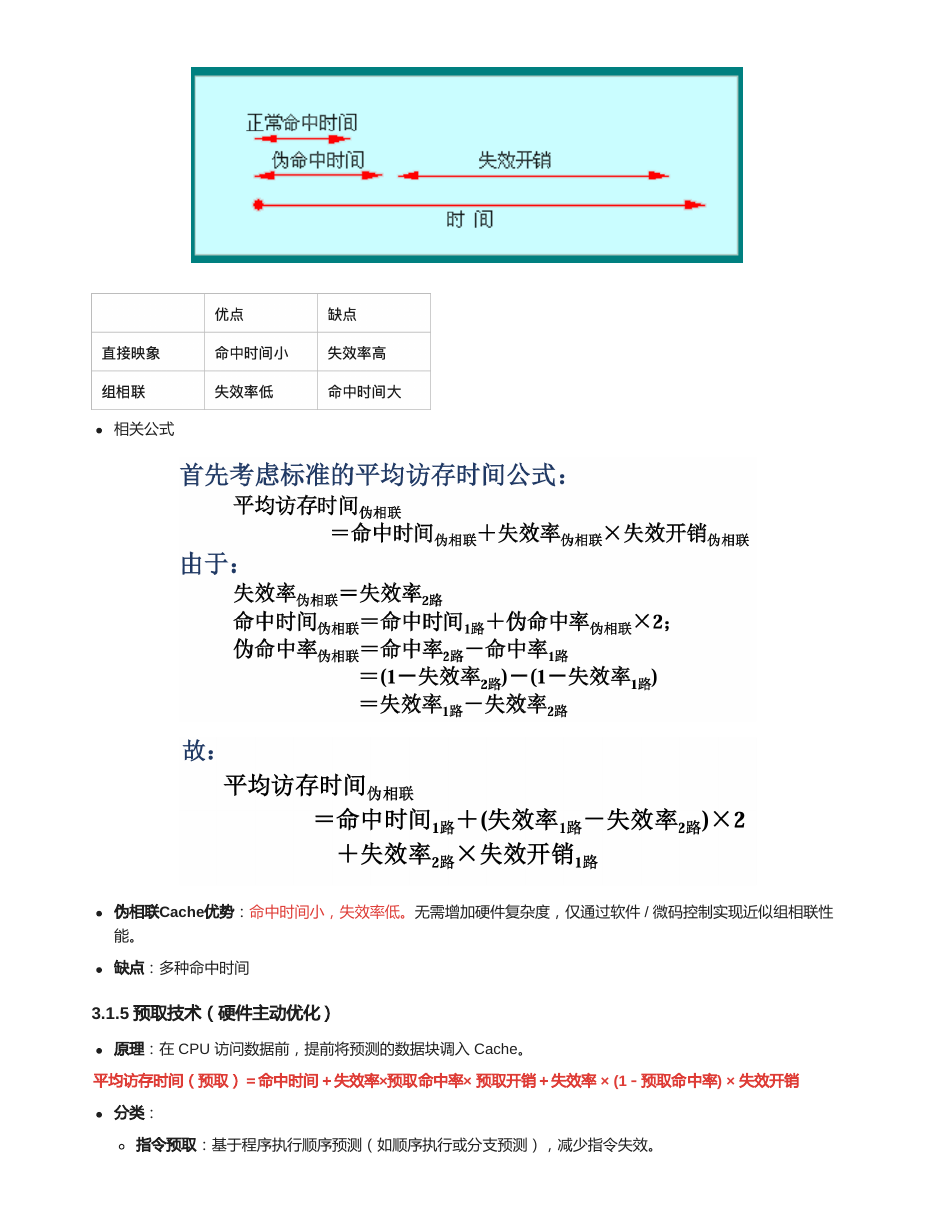
直接映像第一次没命中、另一区命中叫伪命中;两路也找不到才是真失效。
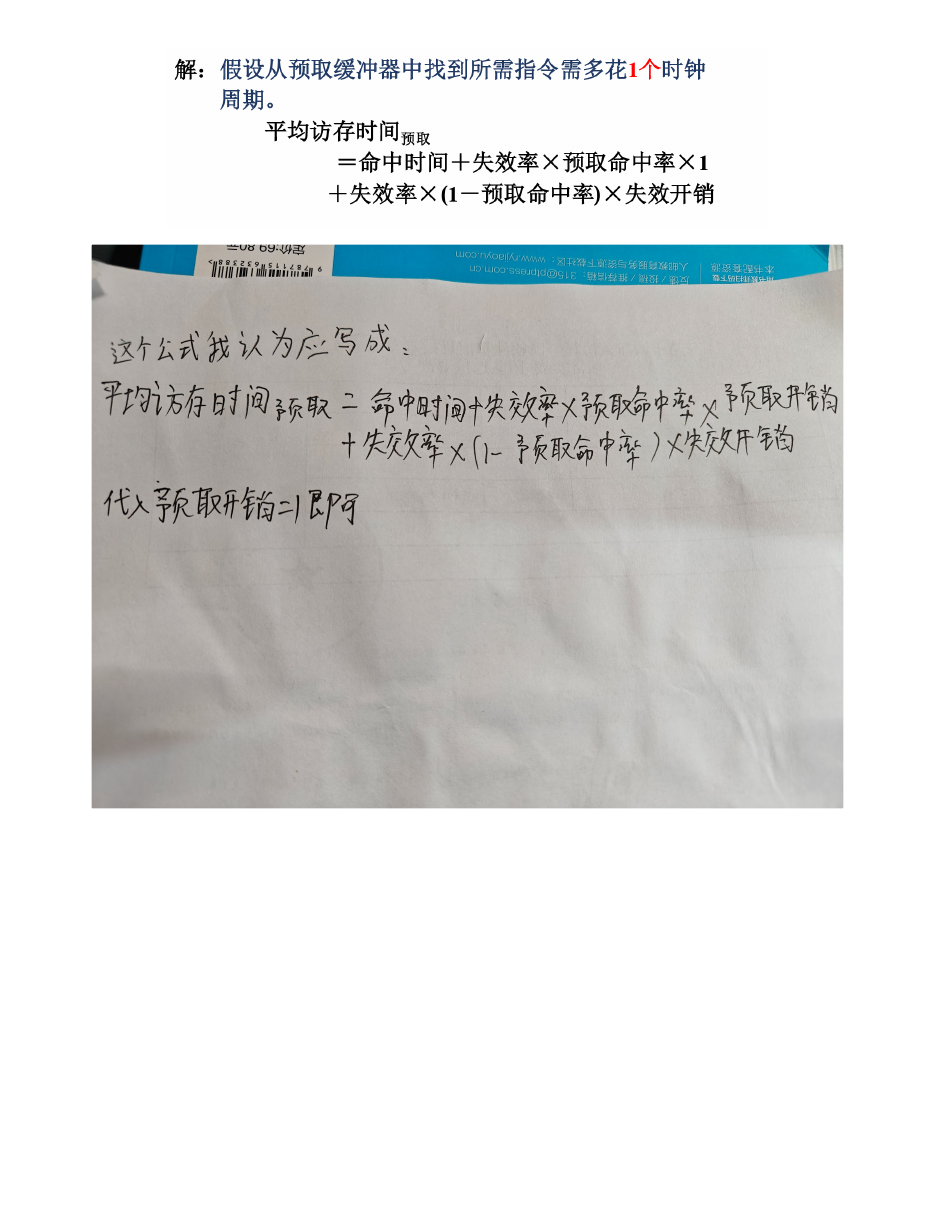
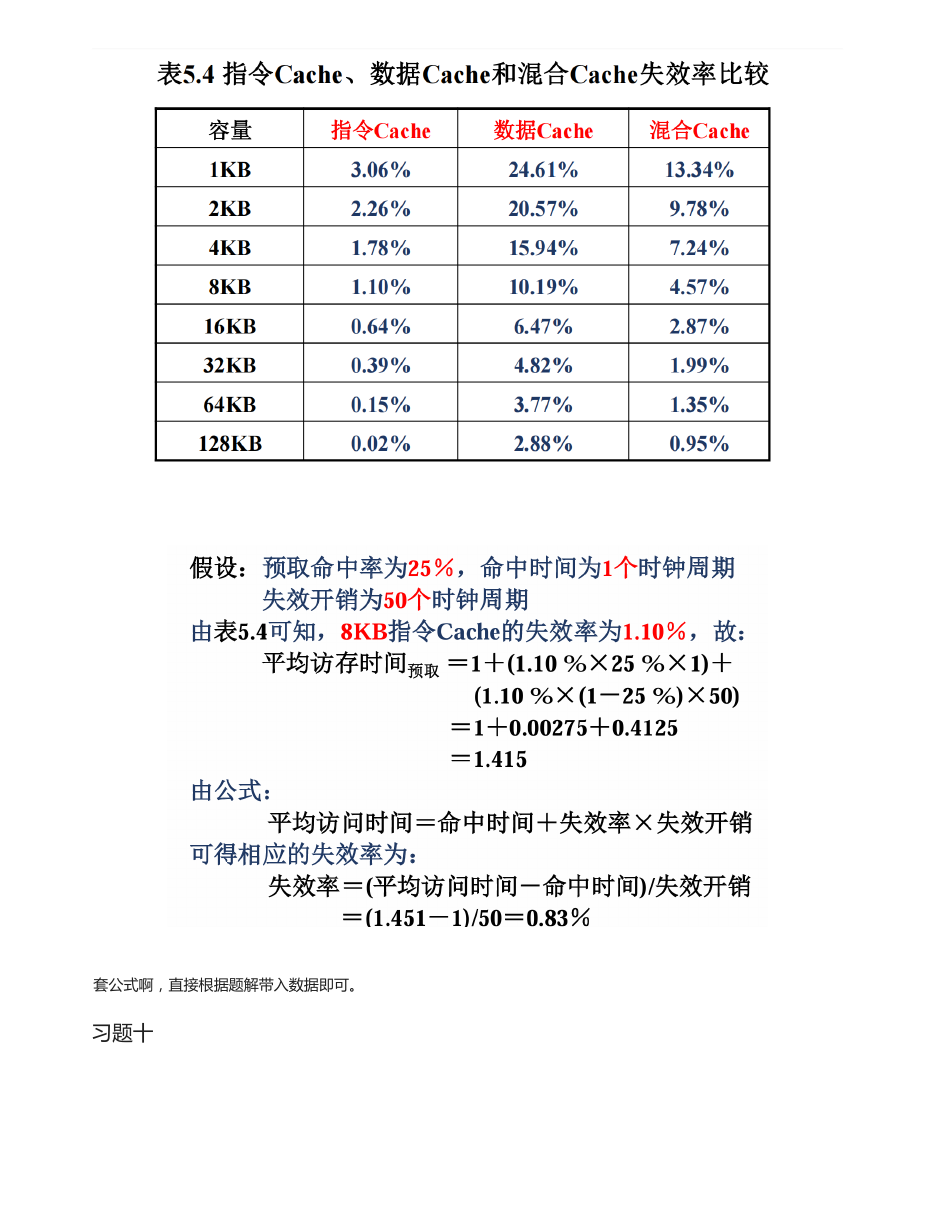
预取命中率表示“本来会失效的访问中,有多少被预取提前解决”。
| 结构 | 失效开销模型 |
|---|---|
| 普通窄主存 | 块大小 x (送地址 + 访问时间 + 传送时间) |
| 多体交叉 | 送地址 + 访问时间 + 块大小 x 传送时间 |
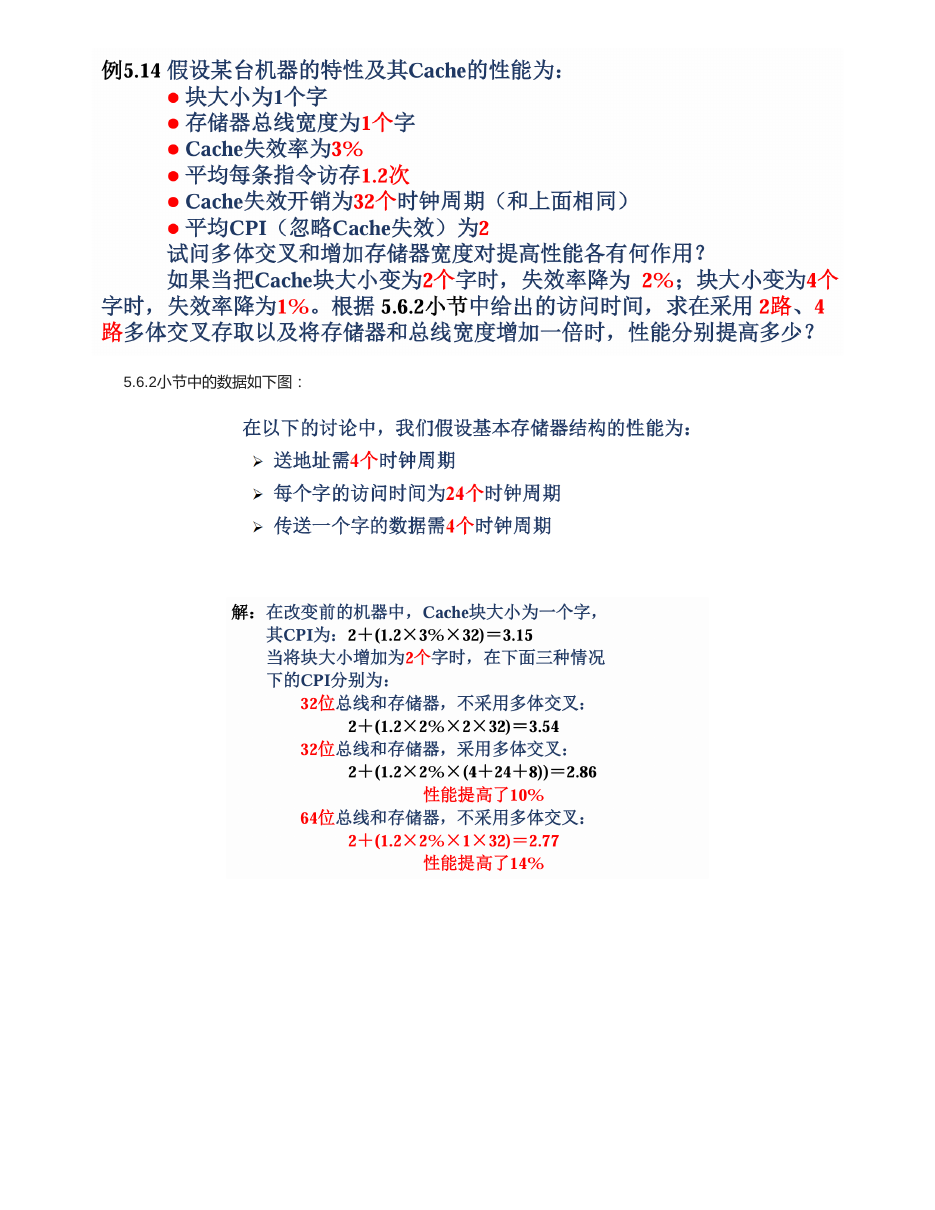
| 总线/存储器加宽 r 倍 | (块大小/r) x (送地址 + 访问时间 + 传送时间) |
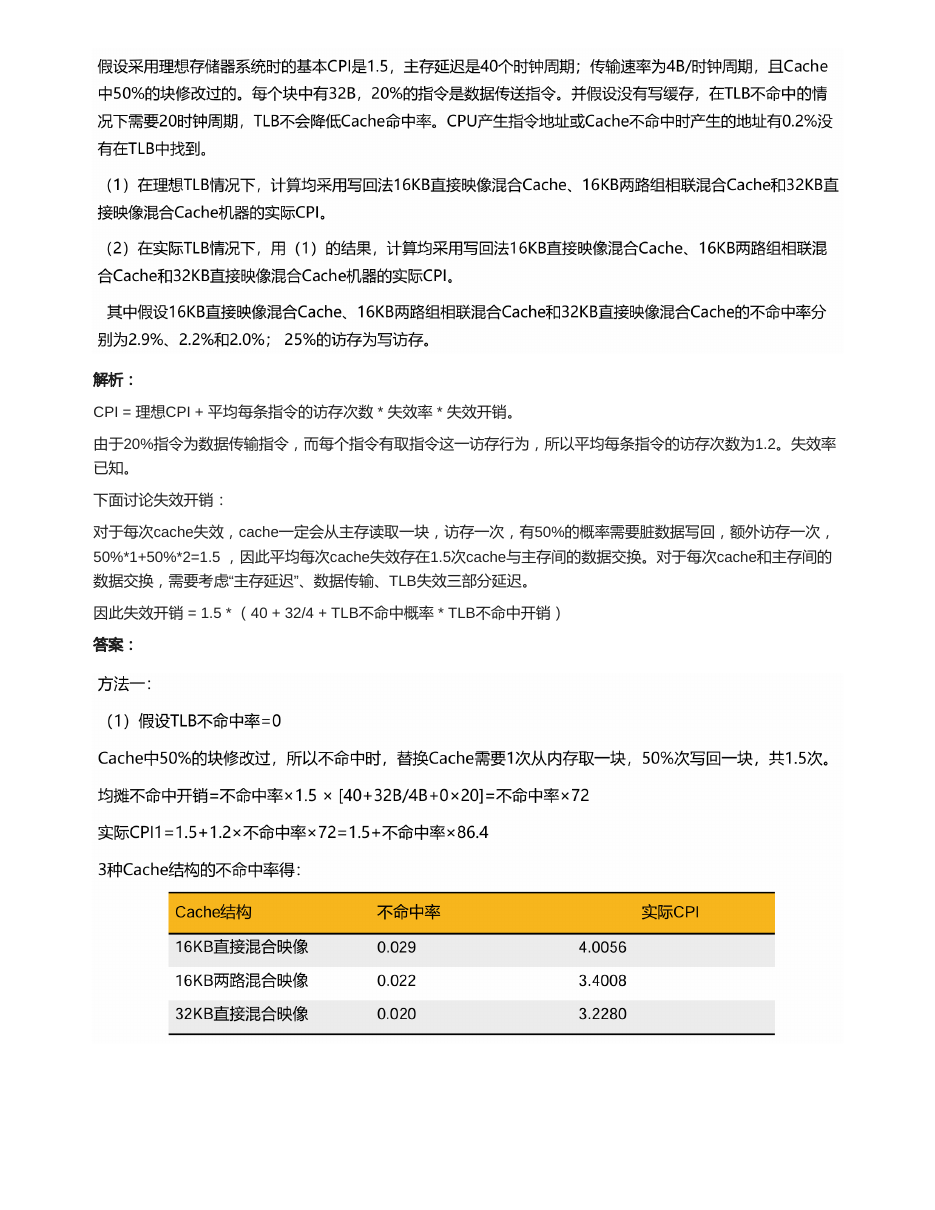
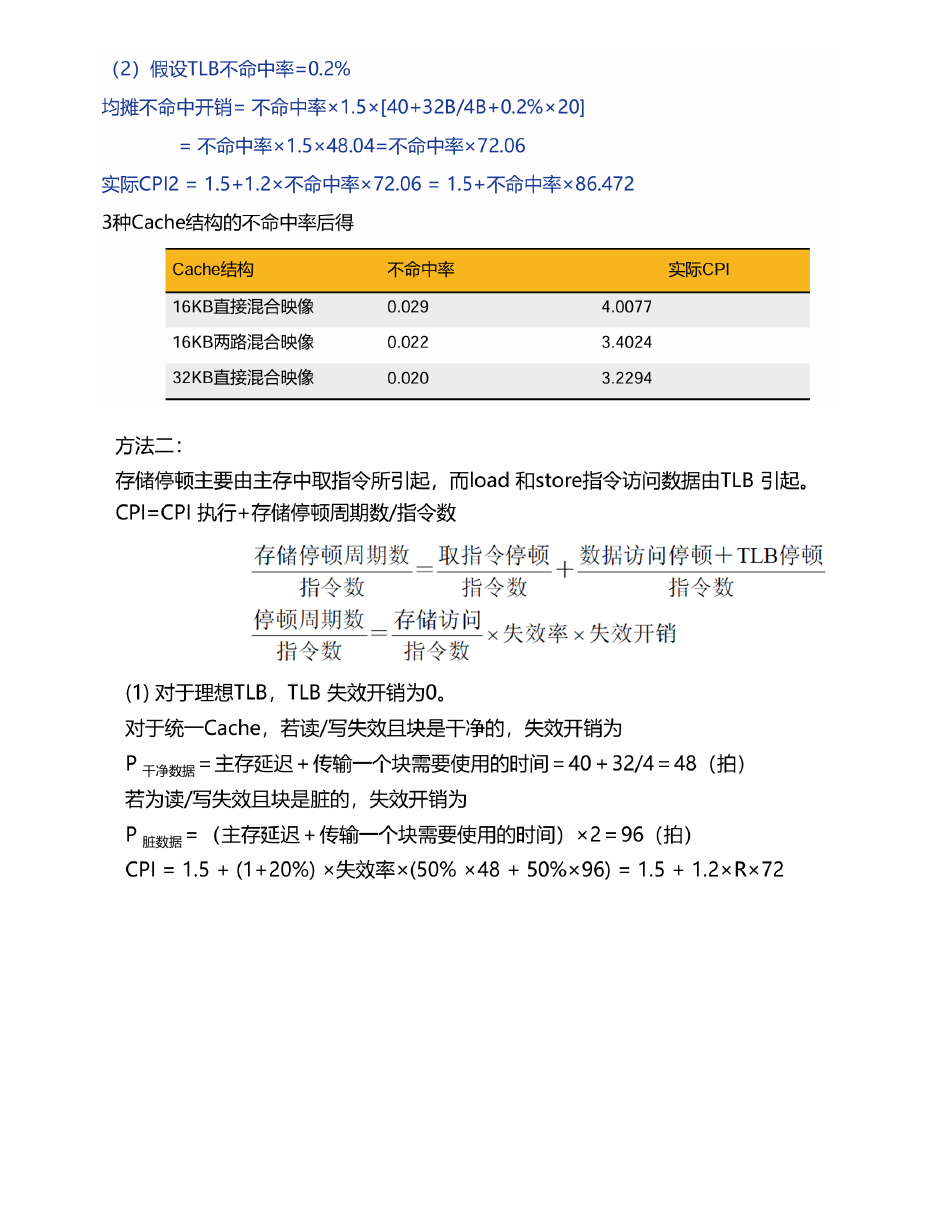
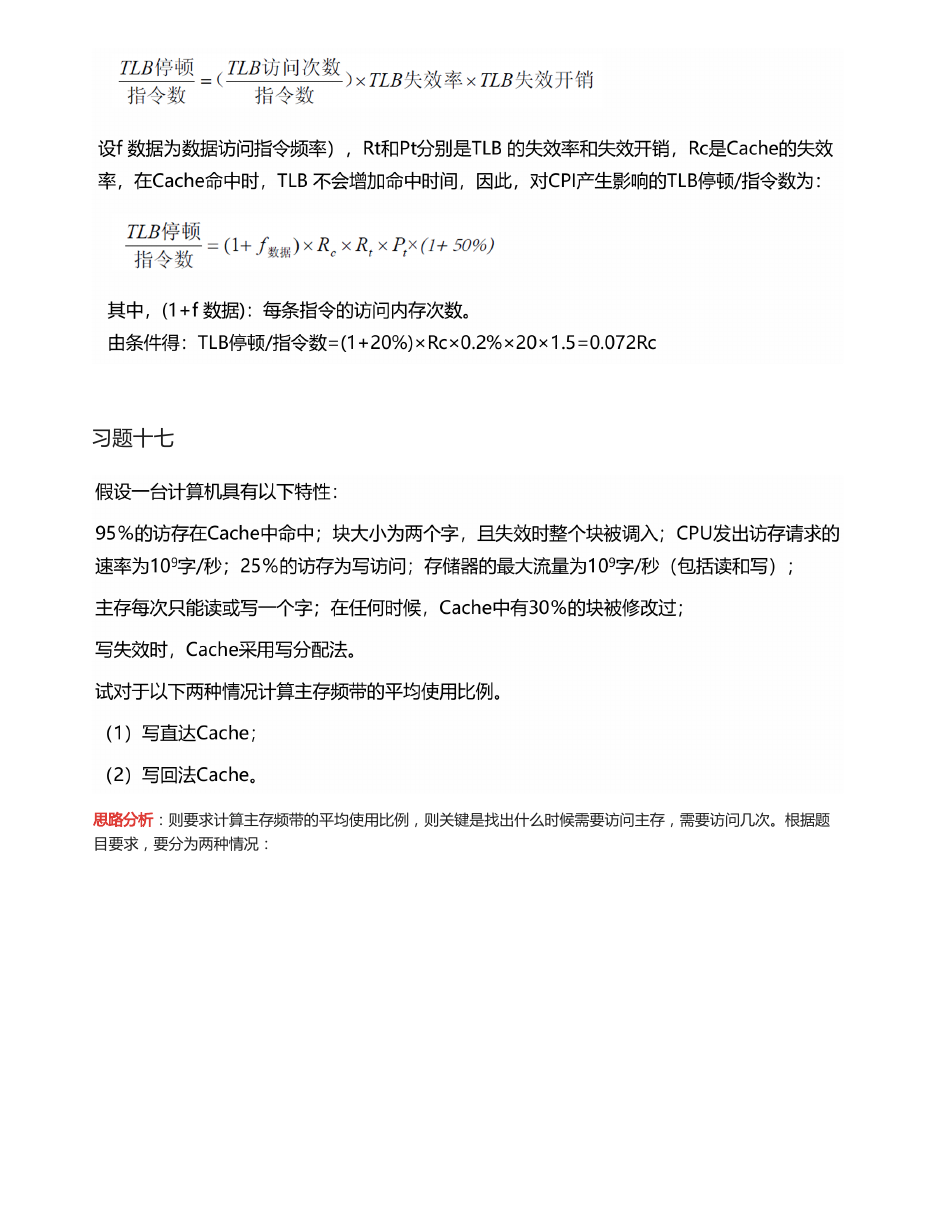
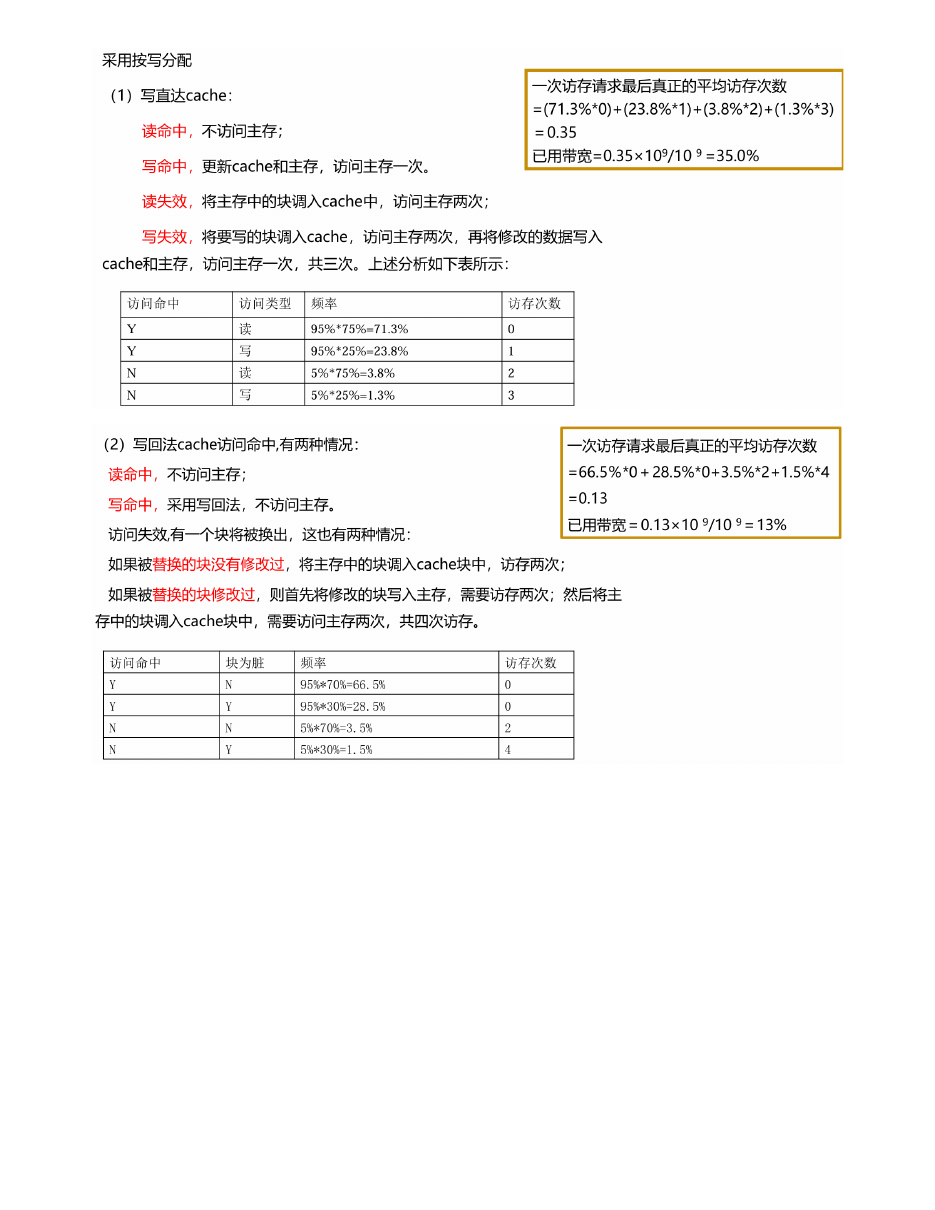
如果每次 Cache 失效一定读入一个块,且有 50% 概率需要脏块写回,则平均每次失效的数据交换次数为:
若主存延迟 40 周期,块大小 32B,每次传 4B,TLB 不命中率 0.2%,TLB 不命中开销 20 周期:
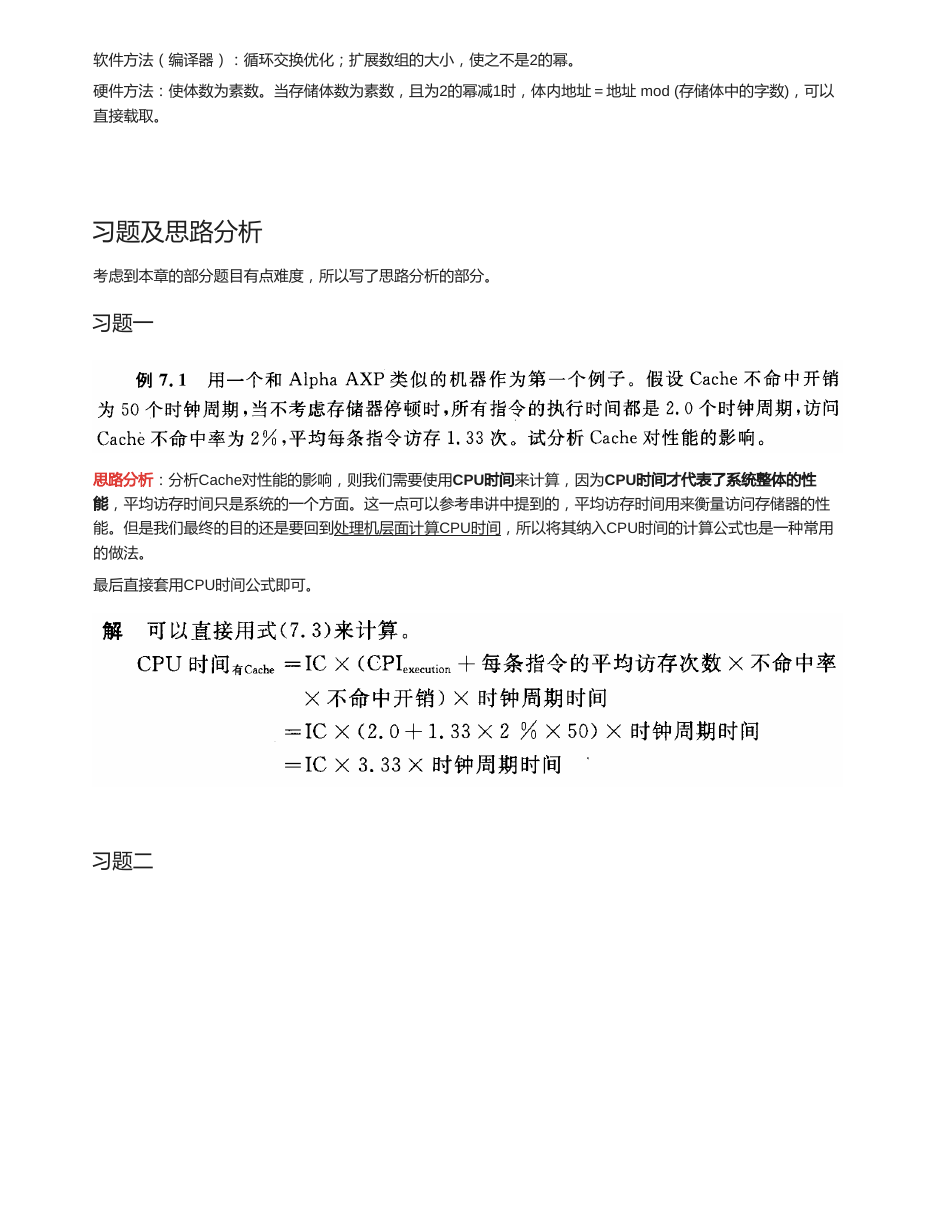
用一个和 Alpha AXP 类似的机器作为例子:Cache 不命中开销为 50 个时钟周期;不考虑存储器停顿时,所有指令执行时间都是 2.0 个时钟周期;访问 Cache 的不命中率为 2%;平均每条指令访存 1.33 次。试分析 Cache 对性能的影响。
CPU 时间 = IC x (CPIexecution + 每条指令平均访存次数 x 不命中率 x 不命中开销) x 时钟周期。
代入得 CPU 时间 = IC x (2.0 + 1.33 x 2% x 50) x 时钟周期 = IC x 3.33 x 时钟周期。
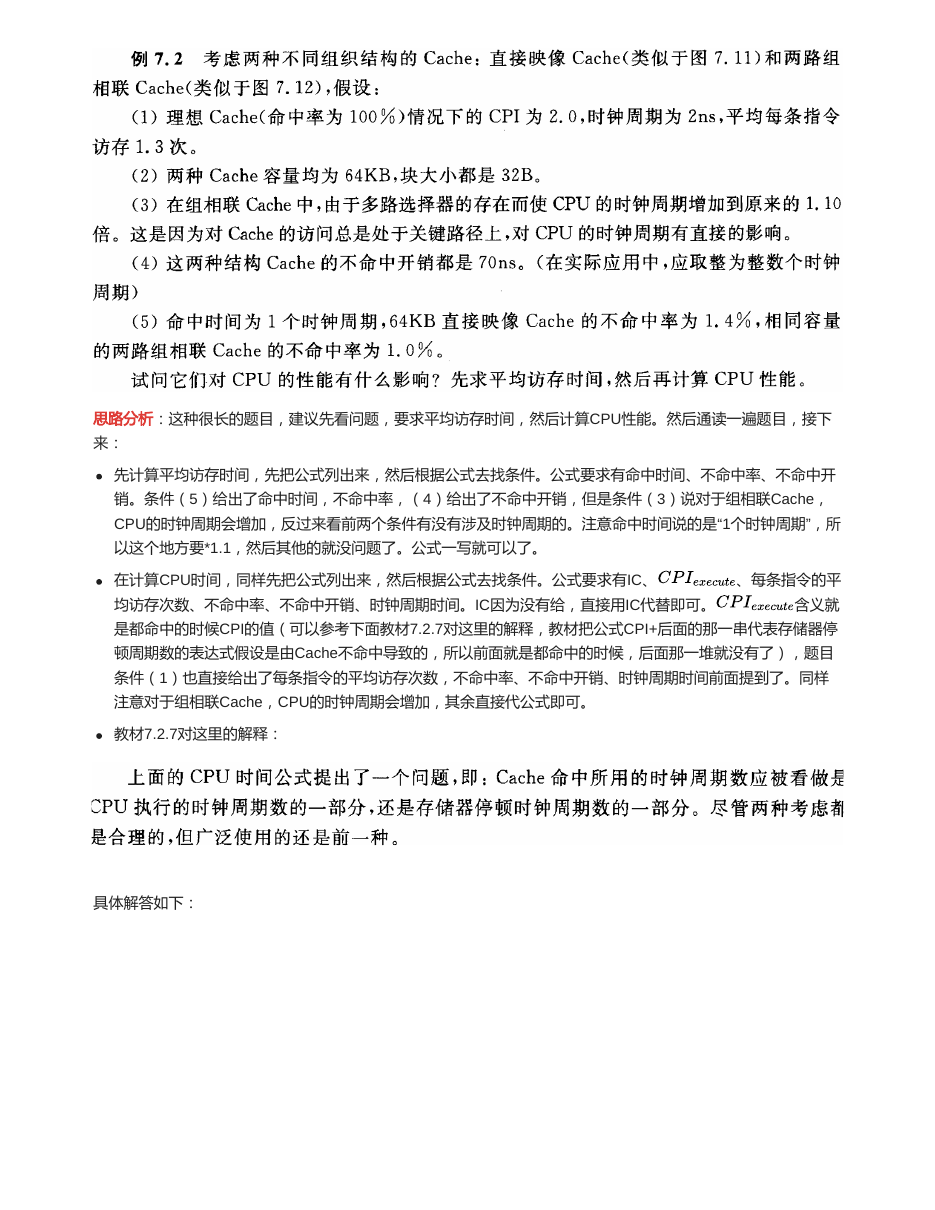
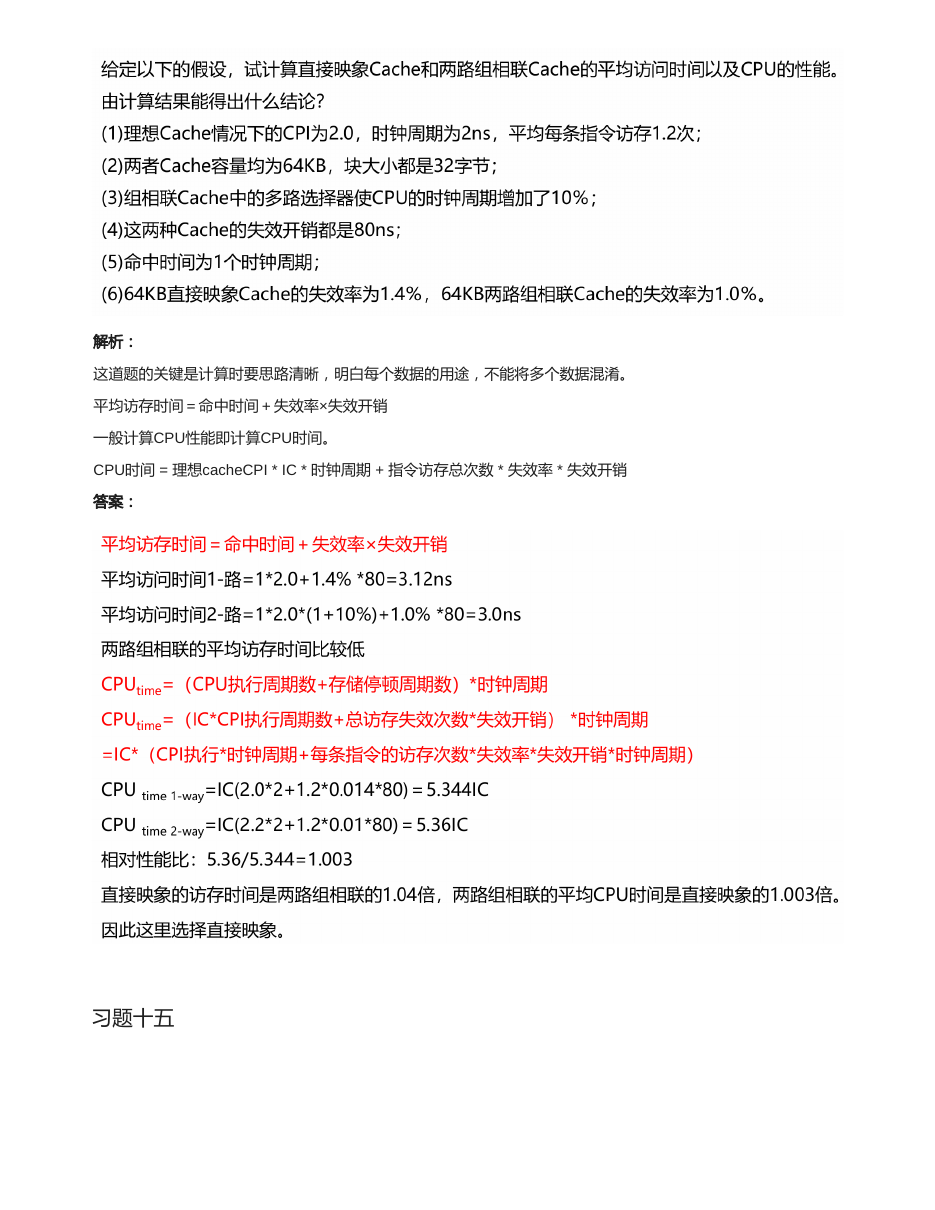
比较 64KB、32B 块大小的直接映像 Cache 和两路组相联 Cache。理想 Cache CPI 为 2.0,时钟周期 2ns,平均每条指令访存 1.3 次。组相联使 CPU 时钟周期增至原来的 1.10 倍;两种结构不命中开销均为 70ns;命中时间为 1 个时钟周期;64KB 直接映像不命中率 1.4%,两路组相联不命中率 1.0%。问平均访存时间和 CPU 性能如何?
平均访存时间:直接映像 = 2.0 + 0.014 x 70 = 2.98ns;两路组相联 = 2.0 x 1.10 + 0.010 x 70 = 2.90ns。
CPU 时间:直接映像约为 5.27 x IC;两路组相联约为 5.31 x IC。虽然两路组相联 AMAT 更低,但 CPU 时钟周期变长,所以按 CPU 时间直接映像略好。
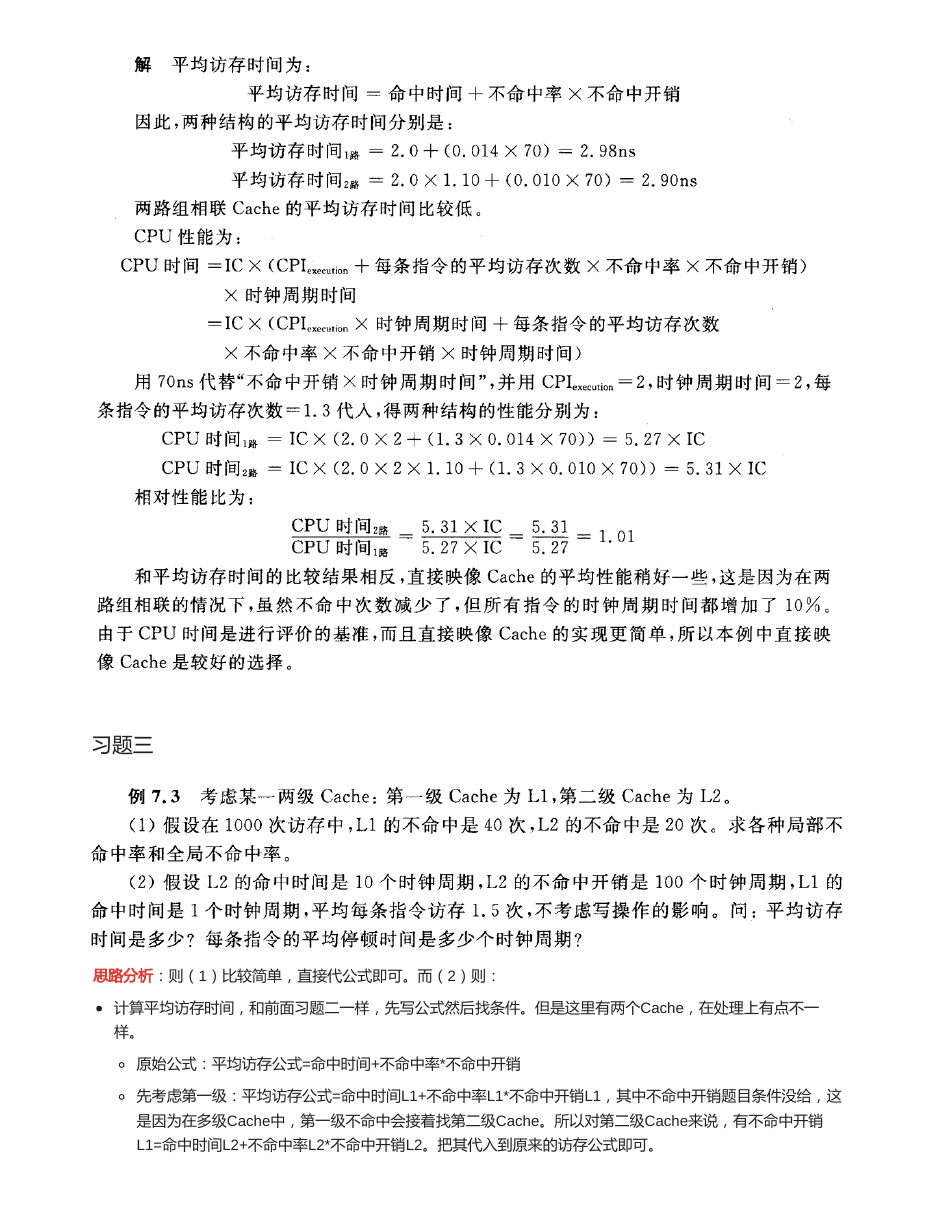
L1 不命中率 = 40/1000 = 4%;L2 局部不命中率 = 20/40 = 50%;L2 全局不命中率 = 20/1000 = 2%。
AMAT = 1 + 4% x (10 + 50% x 100) = 3.4 个时钟周期。
每次访存停顿 = 3.4 - 1.0 = 2.4 周期;每条指令平均停顿 = 2.4 x 1.5 = 3.6 周期。
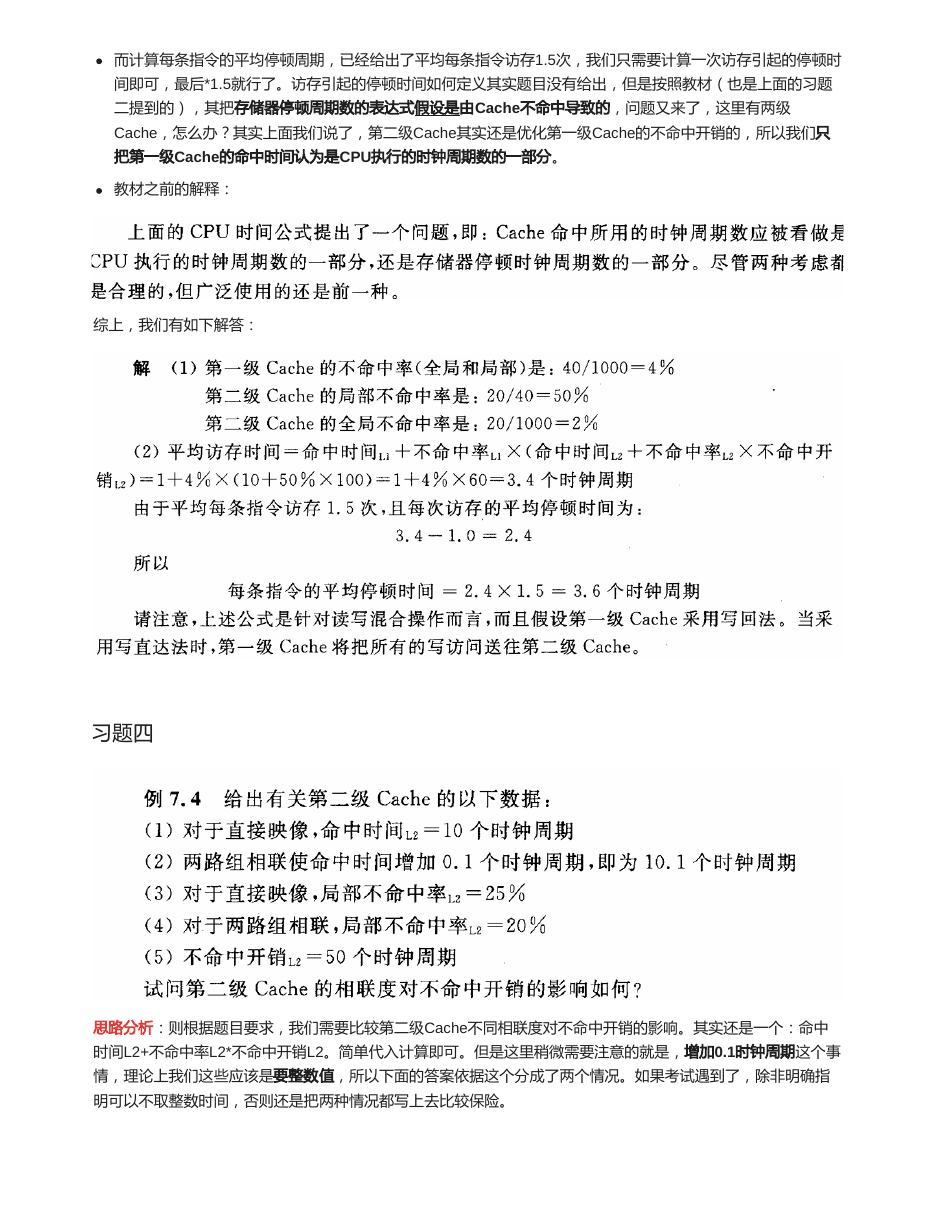
第二级 Cache 数据:直接映像命中时间 10 周期;两路组相联命中时间增加 0.1 周期,即 10.1 周期;直接映像局部不命中率 25%;两路组相联局部不命中率 20%;不命中开销 50 周期。试问第二级 Cache 相联度对第一级 Cache 不命中开销有什么影响?
直接映像 L2:L1 不命中开销 = 10 + 25% x 50 = 22.5 周期。
两路组相联 L2:L1 不命中开销 = 10.1 + 20% x 50 = 20.1 周期。若机器要求命中时间取整,可讨论取 10 或 11 周期两种情况。
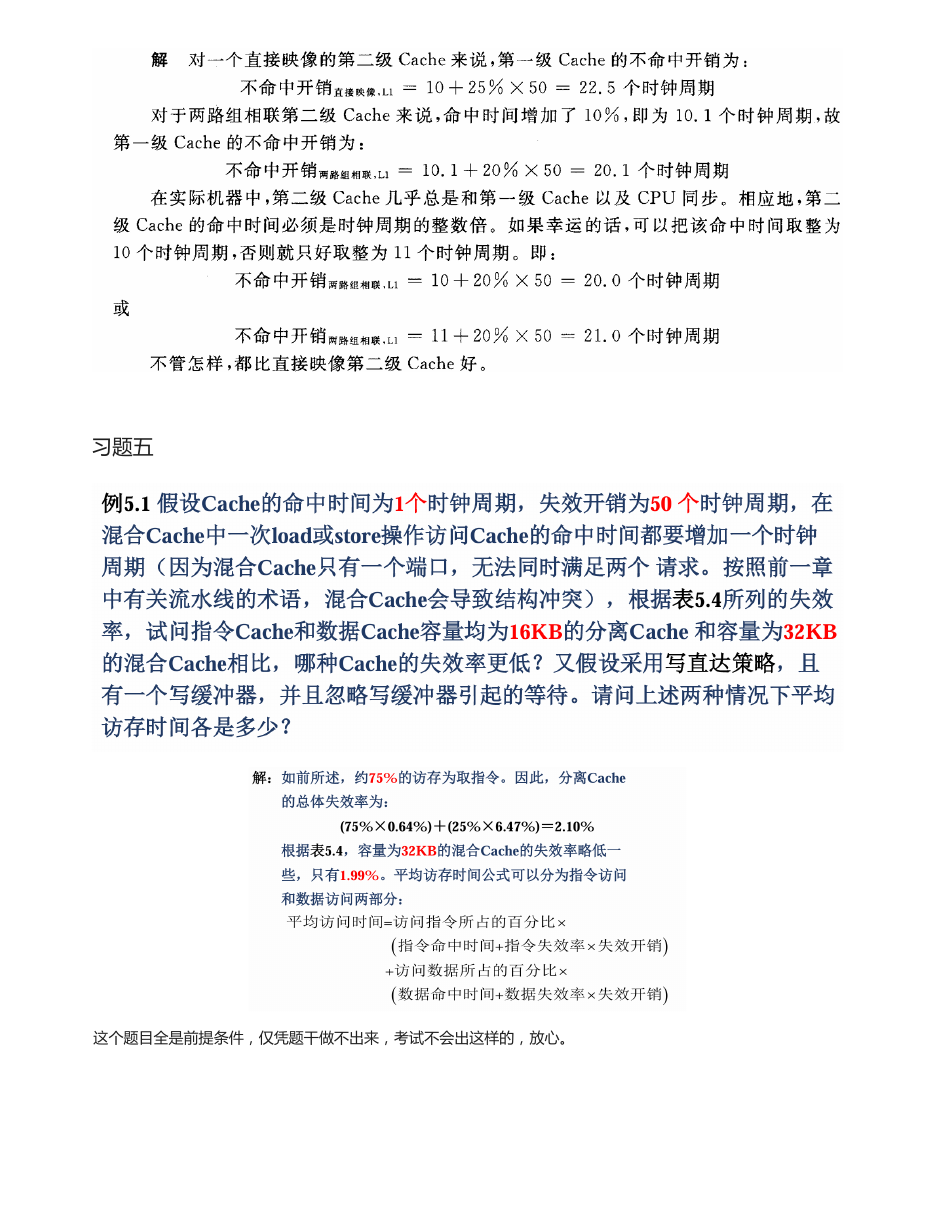
假设 Cache 命中时间为 1 个时钟周期,失效开销为 50 个时钟周期。在混合 Cache 中一次 load/store 访问 Cache 的命中时间都要增加 1 个时钟周期。根据表中失效率,比较指令 Cache 和数据 Cache 容量均为 16KB 的分离 Cache 与容量为 32KB 的混合 Cache:哪种失效率更低?两种情况下平均访存时间分别是多少?
约 75% 访存为取指令,25% 为数据访问。16KB 分离 Cache 总失效率 = 75% x 0.64% + 25% x 6.47% = 2.10%。
32KB 混合 Cache 失效率为 1.99%,失效率略低。
平均访存时间:分离 Cache = 75% x (1 + 0.64% x 50) + 25% x (1 + 6.47% x 50) = 2.05;混合 Cache = 75% x (1 + 1.99% x 50) + 25% x (1 + 1 + 1.99% x 50) = 2.24。
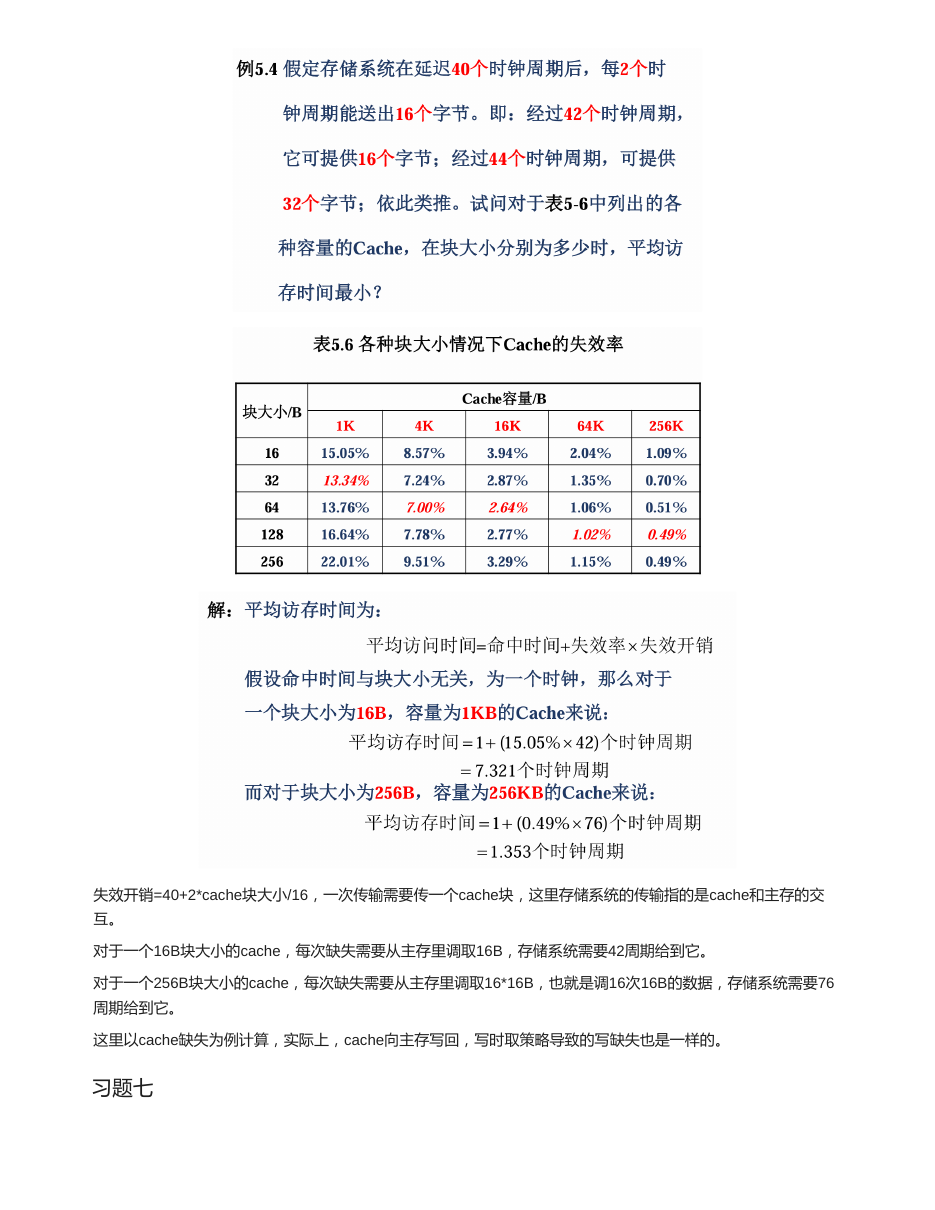
假定存储系统在延迟 40 个时钟周期后,每 2 个时钟周期能送出 16 个字节。即经过 42 个时钟周期可提供 16B,44 个时钟周期可提供 32B,依此类推。试问对表 5.6 中各种容量的 Cache,块大小分别为多少时平均访存时间最小?
对每个容量和块大小计算:AMAT = 命中时间 + 失效率 x 失效开销。命中时间假设与块大小无关,为 1 个周期。
失效开销 = 40 + 2 x 块大小/16。然后逐格比较表中失效率对应的 AMAT,原资料中红色数值就是每列较优选择。
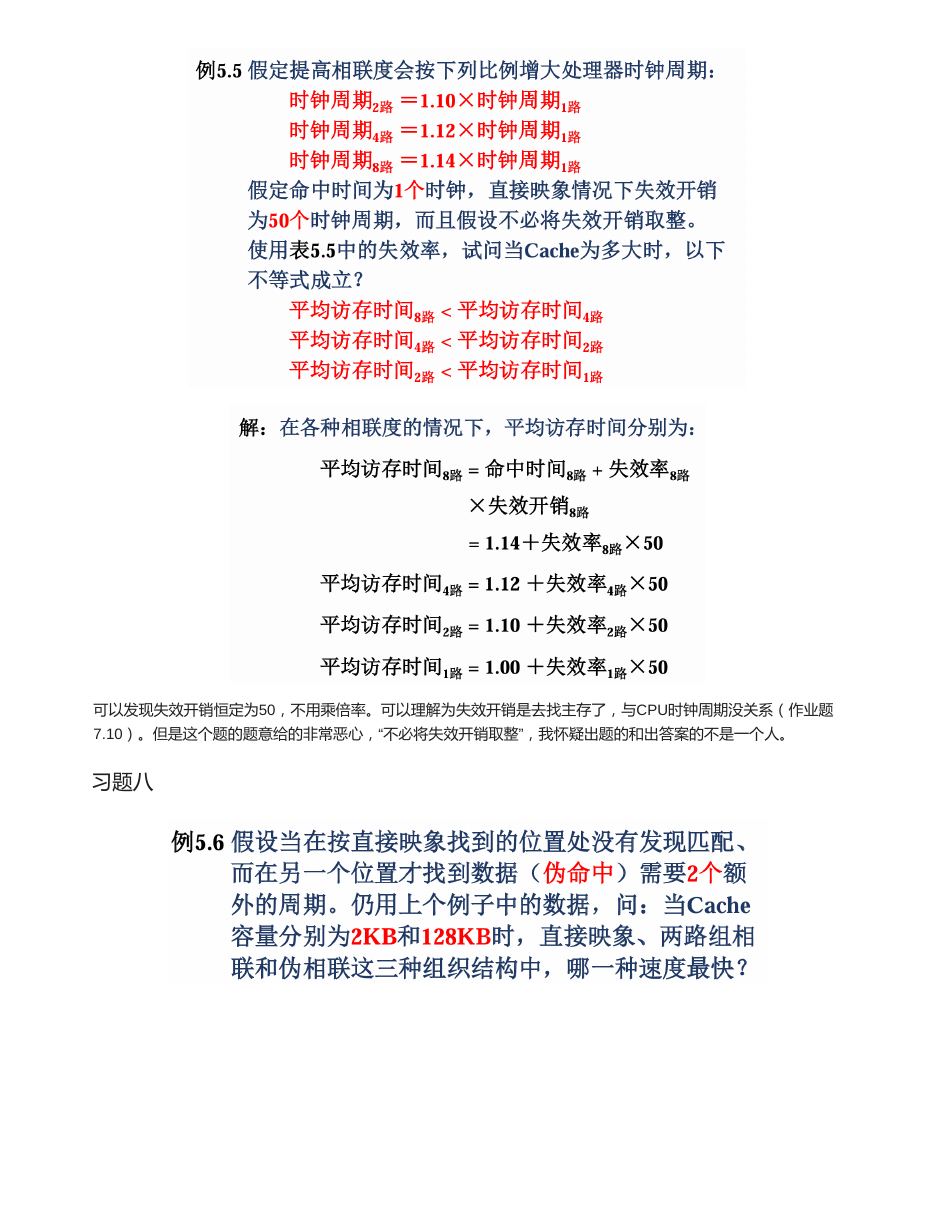
假定提高相联度会按下列比例增大处理器时钟周期:2 路 = 1.10 x 直接映像时钟周期,4 路 = 1.12 x,8 路 = 1.14 x。命中时间为 1 个时钟周期,直接映像下失效开销为 50 个时钟周期,且不必将失效开销取整。使用表 5.5 中的失效率,问当 Cache 多大时满足:8路平均访存时间 < 4路 < 2路 < 1路?
分别计算:8路 AMAT = 1.14 + MR8 x 50;4路 AMAT = 1.12 + MR4 x 50;2路 AMAT = 1.10 + MR2 x 50;1路 AMAT = 1.00 + MR1 x 50。
逐个 Cache 容量代入表 5.5 失效率,找满足不等式的容量。
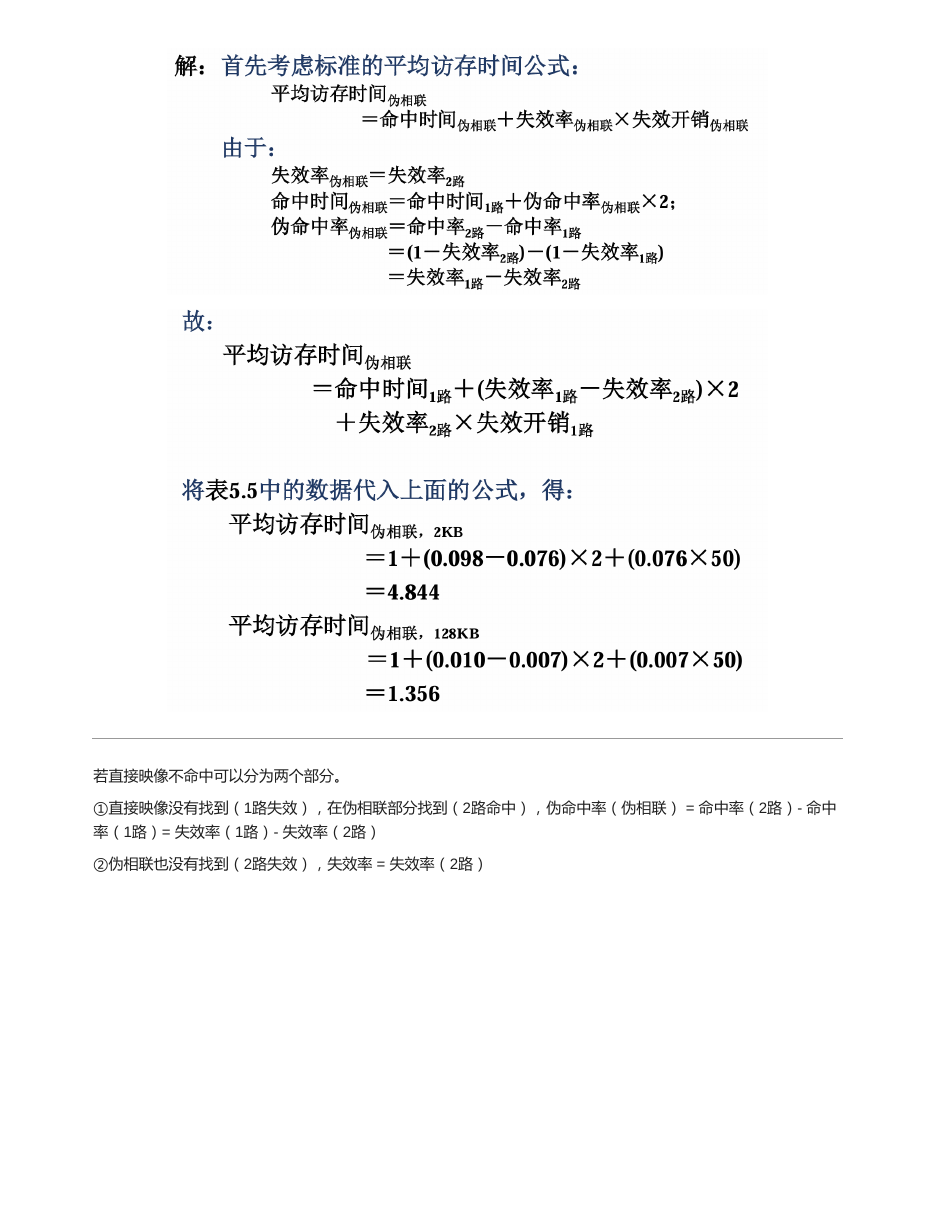
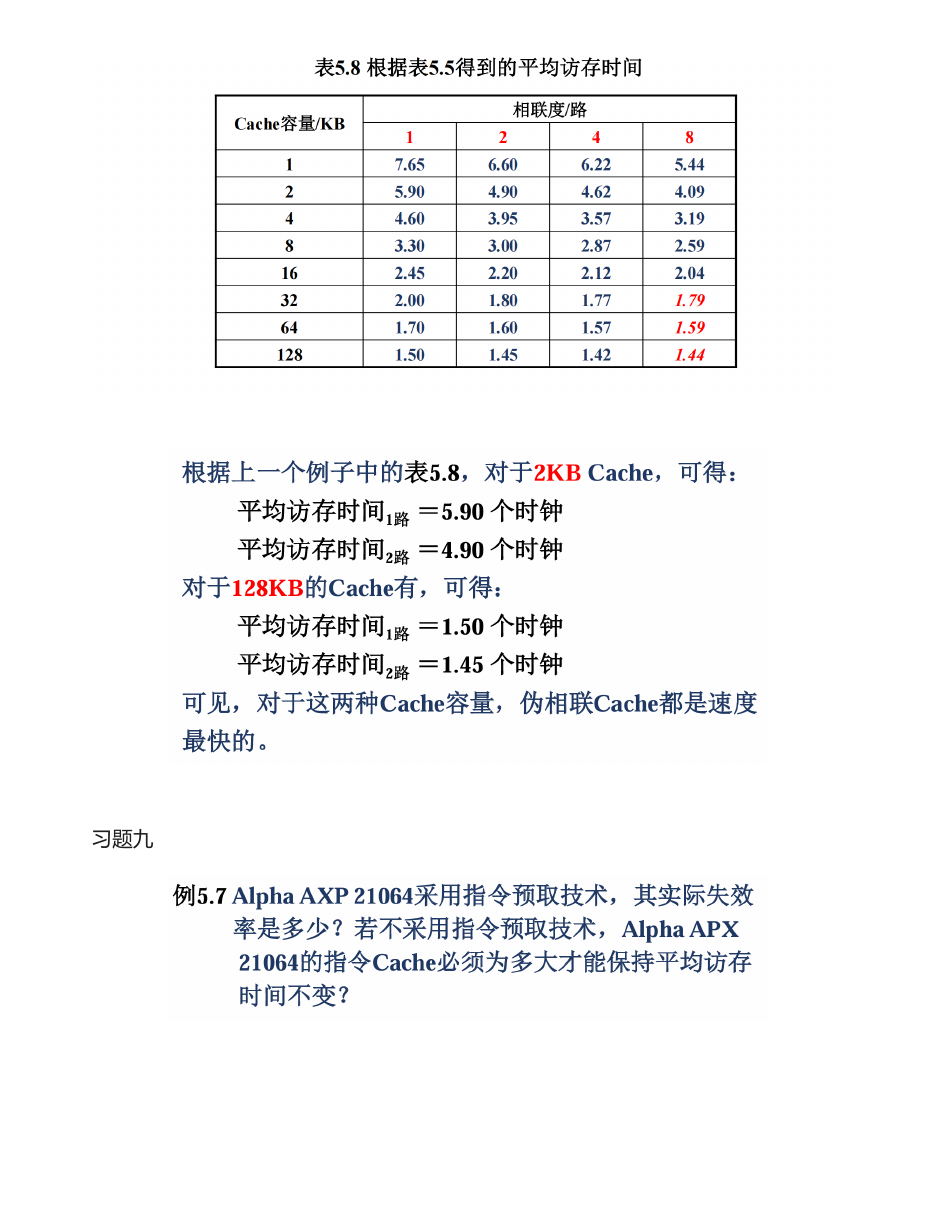
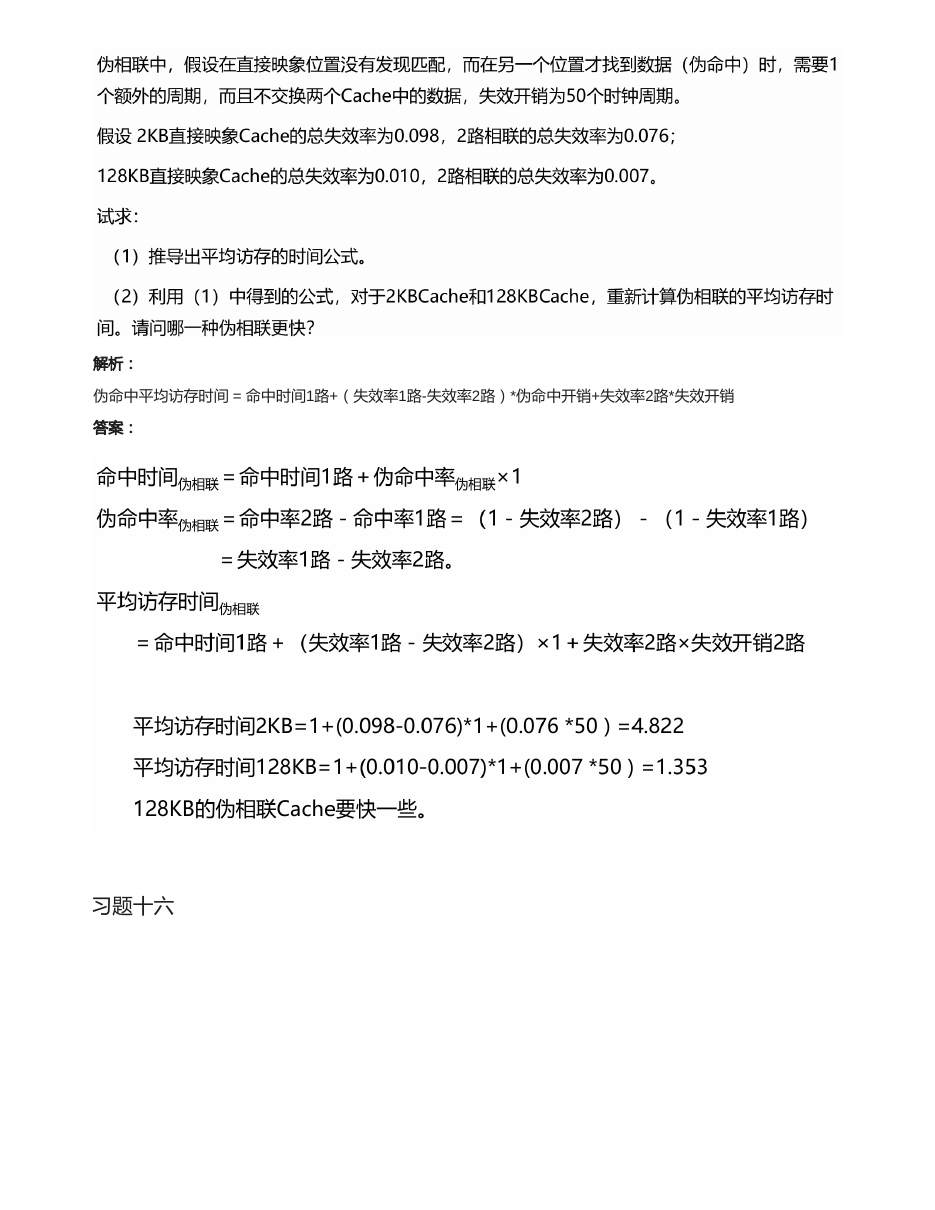
假设当在直接映像找到的位置没有发现匹配,而在另一个位置才找到数据,即伪命中,需要 2 个额外周期。仍用前一例数据,问当 Cache 容量分别为 2KB 和 128KB 时,直接映像、两路组相联和伪相联三种组织结构中哪一种速度最快?
伪相联平均访存时间 = 直接映像命中时间 + (直接映像失效率 - 两路组相联失效率) x 伪命中开销 + 两路组相联失效率 x 真失效开销。
分别代入 2KB 和 128KB 的直接映像/两路组相联失效率比较。
合上正文后先试着口答,再展开看答案。能把这些问题讲清楚,本章主线基本就稳了。
先算块内偏移位数 log2(块大小),再算组索引位数 log2(组数),剩余为标记位。
全相联冲突少但查找复杂;直接映像简单快但冲突多;组相联在二者之间折中。
写回命中时只改 Cache、替换脏块时再写主存;写直达每次写命中都同步写下一级。
局部失效率以到达 L2 的访问为分母;全局失效率以所有访存为分母,等于 L1 失效率乘 L2 局部失效率。
连续地址分布到不同存储体,各体可并行工作,从而在访存周期内传回更多数据。
下面是原资料的页面渲染图,正文复习完后可以展开对照图、公式和例题。